第十三章:数学基础、位运算与高精度
第十三章 数学基础、位运算与高精度
同一个整数,换一种表示方式,就可能让原本困难的计算变得清楚。把数写成各数位,可以转换进制;把数拆成质因子的乘积,可以看出整除关系;把是否选择写成二进制位,可以枚举子集。当整数已经长到普通类型装不下时,还可以自己保存每一位,按竖式计算。
本章沿着四条相互联系的线索展开:进制与二进制位、整除与质数、余数与计数、高精度整数。每个单元都先用较小的整数手算,再说明程序要保存什么。根式、前缀异或的区间选择和几何范围检查放在相应基础之后,阅读时可按前置知识逐段推进。
阅读前需要掌握整数除法、数组、循环、函数,以及第四章的前缀和。涉及递推、贪心和搜索的地方会说明与前面章节的联系。代码使用 C++17;代码以教学函数或操作片段给出,运行时需要补头文件、输入输出与调用;互质因数对复用 gcd,根式化简复用 factor,高精度单元共用数位数组与辅助函数。数学中的余数与 C++ 的 % 在负数上需要额外区分。
1. 进制:每一个数位代表多少
先看十进制中熟悉的计算
十进制的 表示两个百、三个十和七个一:
位置决定了同一个数码代表的大小。最右边的位置代表 ,向左移动一位,它代表的单位扩大到原来的 倍。“十进制”中的十,正是相邻数位单位的倍数。
二进制把这个倍数换成 ,每位只允许写 或 。例如
下标 表示二进制,不是乘以二。十六进制每位需要十六种数码,约定 A 至 F 分别代表 至 ,所以 (2F) 的十六进制数值为 。
图中每列的乘积表示这一位对整个数的贡献。左侧数码并不总是比右侧大;决定贡献大小的是“数码乘该位置的单位”。例如二进制 1011 的第一个 1 贡献 ,最后一个 1 只贡献 。
从左到右读入:原结果乘进制,再接新数位
不必对每个数位单独计算幂。已经读入十进制前缀 ,再读入 7,就是 。在源进制 下也一样:旧前缀整体左移一位,贡献扩大 倍,再加新数位 。
以十六进制 2F 为例:
| 读入数码 | 数位值 | 旧值 | 新值 |
|---|---|---|---|
2 | |||
F |
这里的字符 F 和数值 是两种对象。输入串里只有一个字符,计算时必须先把它转换成对应的数位值。
从低位取余:输出时为什么需要反转
把十进制数值 写成二进制。除以 时,余数就是最低位,商是删去最低位后剩余的值。继续对商做同样的事:
| 当前数值 | 除以 的商 | 余数,也就是本轮取出的低位 |
|---|---|---|
依次取到的是从低位到高位的 111101,反过来才是通常从高位向低位书写的 101111。整数 也有一个数位,不能输出空串。
下面把两步接起来,解决进制转换所代表的一类任务。函数中的输入进制和输出进制分别为 b、c;这里明确限定 ,数码使用大写字母,输入合法且数值不超过 。
int digit(char c)
{
    if (c >= '0' && c <= '9')
    {
        return c - '0';
    }
    return c - 'A' + 10;
}

string convert(int b, int c, string s)
{
    string ch = "0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ", ans;
    long long x = 0;
    for (char v : s)
    {
        x = x * b + digit(v);
    }
    do
    {
        ans += ch[x % c];
        x /= c;
    } while (x > 0);
    reverse(ans.begin(), ans.end());
    return ans;
}第一段循环对应“乘源进制、加新数位”;第二段对应“除目标进制、取低位”,do 保证零也执行一次。设输入、输出长度分别为 ,时间为 ,输出空间为 。由于输入数值非负,各个已读前缀不会超过最终值,本节的范围允许用 long long;若输入已有数百位,则不能先转成内置整数,应使用后面的高精度表示。
2. 二进制位:从逐位计算到子集
位运算操作的是同一位置上的两个数码
取 、,先把数位对齐,再分别处理每一列。
| 操作 | 二进制结果 | 十进制结果 | 一列中的规则 |
|---|---|---|---|
与 x & y | 010 | 两位都为 才得 | |
或 x | y | 111 | 至少一位为 就得 | |
异或 x ^ y | 101 | 两位不同才得 |
异或可以先理解为“这一位是否不同”。它不是乘方;C++ 的 ^ 也不表示指数。逻辑与 && 处理的是整个表达式的真假,例如 和 都非零,所以逻辑与为真;按位与先对齐 10、01,结果却为 。
位从最低位开始编号为 。左移 x << k 把位移向更高位置,右移 x >> k 移向更低位置。本节的非负值在类型范围内左移一位,相当于乘 ;右移一位相当于整除 。越过类型宽度的移位不能使用;讨论整个位模式时优先用明确宽度的无符号类型。
三个开关就是八个下标子集
把第 位为 理解为“选择第 个元素”,一个整数就可以同时保存多项选择。这种用位代表选择的整数常叫掩码。这里数组下标从 开始;显示二进制时高位写在左侧,因此最右位对应 a[0]。
以 为例:
| 掩码 | 选择的下标 | 选择的数 | 和 |
|---|---|---|---|
000 | 空集 | 无 | |
001 | |||
010 | |||
011 | |||
100 | |||
101 | |||
110 | |||
111 |
每个下标独立决定选或不选,所以 个下标共有 种选择;每种选择都对应唯一的二进制位串。第十章用递归逐步决定选择,这里把整组选择写成一个整数。相同数值来自不同下标时,仍由不同位表示。
以下统计和等于目标 的下标子集数,允许空集。令 、每个元素绝对值不超过 ;a、n、k 已读入。
int n;
long long a[20], k;

int count()
{
    int ans = 0;
    for (int s = 0; s < (1 << n); s++)
    {
        long long sum = 0;
        for (int i = 0; i < n; i++)
        {
            if ((s >> i) & 1)
            {
                sum += a[i];
            }
        }
        if (sum == k)
        {
            ans++;
        }
    }
    return ans;
}
(s >> i) & 1 先把第 位移到最低位,再只取这一位。每个掩码检查 位,时间为 ,辅助空间为 ;答案最多 ,但元素和可能达到 ,故和使用 long long。若题目只允许非空子集,就从掩码 开始。
修改单个位时,先构造 1ULL << i,即只有第 位为 的无符号掩码。与它取或能设位;与它取异或能翻位;与它的按位取反取与能清位。例如 1010 的第 位设为 得 1011,第 位清零得 1000。取反 ~ 翻转的是类型宽度内的所有位,并非图中省略前导零后的几个数位;构造 64 位掩码时必须满足 。
3. 最低的一个 1:先看减一时发生了什么
二进制 1100 减去一,要向左借位:最低的那个 变为 ,它右边的零全部变为 ,得到 1011。更高位保持不变。因此把原数与减一后的数按位与,正好去掉原来最低的一个 。
在图中,原来最低的 对应 ,相与之后只剩 。不断重复这个操作,就能用循环次数统计 的个数: 的位串依次为 1101 → 1100 → 1000 → 0000,共三次。
int count(unsigned long long x)
{
    int ans = 0;
    while (x > 0)
    {
        x &= x - 1;
        ans++;
    }
    return ans;
}
零不需要执行循环;每次恰好少一个 ,所以循环次数等于答案,不超过该类型位宽。编译器提供的 __builtin_popcountll 也能完成这个计数,但输入类型和题目所讨论的位宽仍须明确。
若要保留而非删除最低的 ,无符号整数可使用 x & (-x)。在固定宽度下,无符号取负等价于对全部位取反后加一:最低的 及其右边零恢复原样,更高位与原数相反。与原数取与后,只留下最低的一个 。例如以八位展示,00001100 取负得到 11110100,两者取与为 00000100。这个技巧建立在位模式上,不能把负数直接代入“非负整数有多少个 1”的题意。
优秀的拆分要求使用互不相同且大于 的二的整数次幂。二进制位已经决定选择:。奇数必须含单位 ,但它被禁止,因此奇数无解;偶数只需从高位到第 位输出被选中的幂。这里与子集表的关系是:不同位代表不同的二的幂。
4. 前缀异或:相同部分怎样抵消
先把区间查询变成两个前缀
按位异或中,一个位与自己异或得到 ,再与 异或保持原值。因此整个整数也满足 、;交换顺序和改变括号都不改变各位结果。
设 ,。求区间 时, 包含从开头到 的所有元素, 再提供一次不需要的左侧部分。这些相同元素两两抵消,留下目标区间:
对 ,前缀依次为 。求 得 ,也等于 。这里沿用第四章“用两个前缀消去相同部分”的想法,但运算换成异或。
再选择尽可能多的不相交区间
异或和要求每段异或值均为 ,选出的非空区间互不相交。固定右端点 ,合法区间的左边界满足
如果上一段结束于 ,新一段必须从 或更后面开始,因此可用的前缀位置应满足 。问题从“试所有左端点”变成了“在这段前缀位置中,有没有目标值”。
对同一个前缀异或值,只记录最近一次出现位置就够了。最近位置仍早于 ,则所有更早位置都不可用;最近位置达到 ,便确实存在可用左界。
以 、 为例:
| 扫描到 | 要寻找的值 | 此前最近位置 | 旧终点 | 本轮选择 | |
|---|---|---|---|---|---|
| 未出现 | 不选 | ||||
| 选 ,令 | |||||
| 选 ,令 |
图中的前缀位置在元素之间:前缀位置 和 确定元素区间 ,前缀位置 和 确定 。两段共用的是一条边界,没有共用元素。
为什么发现一段就可以立即选择?把任意最优方案的第一段换成扫描遇到的最早结束合法段,结束时刻不会更晚,后面的原有区间仍能保留。对剩余后缀重复这个交换,段数不会减少。这与第八章区间调度的“为后面保留空间”是同一种证明方向。
原题 ,元素与 均小于 ,所以异或值也在这个值域内。last 全部初始化为 ,只把空前缀的出现位置设为 。
const int N = 500000 + 10, V = 1 << 20;
int n, k, a[N], last[V];

int solve()
{
    fill(last, last + V, -1);
    last[0] = 0;
    int s = 0, ed = 0, ans = 0;
    for (int i = 1; i <= n; i++)
    {
        s ^= a[i];
        if (last[s ^ k] >= ed)
        {
            ans++;
            ed = i;
        }
        last[s] = i;
    }
    return ans;
}
代码先查以前的前缀,再记录当前前缀,保证 。若 且先写 last[s]=i,当前前缀会与自己配对,错误地构造空区间。初始化耗时 ,扫描耗时 ;最近位置表占 空间。
5. 整除、公约数与因数对
从共同的分组大小认识最大公约数
的正因数为 ; 的正因数为 。两组共有的 是公约数,其中最大的 是最大公约数,记作 。
可以把因数理解成每组放几个:每组放 个时, 和 都能整分。逐个试组大小可行,但数很大时,很多候选没有必要试。
看 。若每组的大小能同时整除 和 ,移走两整份 后,剩下的 也能整分。反过来,若能整除 和 ,把两份 加上 ,也能整分 。因此两对数的公约数完全相同。
只要 ,就有 。反复换成较小的一对:
最后一个非零数为 。每次余数小于除数,过程一定结束;到余数为零时,非零数本身就是最大的共同分组大小。
long long gcd(long long a, long long b)
{
    while (b != 0)
    {
        long long r = a % b;
        a = b;
        b = r;
    }
    return a;
}
函数接受非负整数;实际数论题一般保证至少一个数非零。本章不对 赋予新的数学含义。对于两个正整数,欧几里得算法的取余次数为 ,辅助空间为 :把较大数先放前面后,两轮内较小数至少减半,因而不会线性递减到零。
最小公倍数与最大公约数为什么有联系
的倍数有 , 的倍数有 ,第一个共同正数是 ,叫最小公倍数。
设 ,写成 ,其中 不再含共同因子。一个共同倍数除去 后,必须同时含有 的因子;由于二者互质,最小就是 。因此
程序先除后乘,能减小中间数值,但最终结果仍可能超出类型上限。这里的“互质”表示最大公约数为 ,不表示两数各自必须是质数,例如 与 互质。
用互质因数对统计有序答案
最大公约数和最小公倍数问题给出正整数 ,要求有序正整数对 满足 、。
若 不是 的倍数,无解。否则写成 ,便要求 且 互质。以 为例,只需看 的因数对:
| 无序因数对 | 是否互质 | 还原出的有序 |
|---|---|---|
| 是 | 、 | |
| 否 | 不计 | |
| 是 | 、 |
只枚举较小因数 ,较大因数由除法确定。不同因数对交换顺序要计两次;两因数相等时只计一次。以下复用本节 gcd,要求 ;原题两数不超过 。
int solve(int x, int y)
{
    if (y % x != 0)
    {
        return 0;
    }
    int t = y / x, ans = 0;
    for (int d = 1; d <= t / d; d++)
    {
        if (t % d == 0 && gcd(d, t / d) == 1)
        {
            ans += d == t / d ? 1 : 2;
        }
    }
    return ans;
}
d <= t/d 表示平方根边界,避免先计算 d*d 的乘法。至多检查 个候选,每次互质检查需要对数时间,总时间上界为 。
6. 质数、质因子与平方根
为什么试除到平方根就够了
大于 的正整数中,只有 和自身两个正因数的是质数;有其他正因数的是合数。 既不是质数,也不是合数。
因数总是成对出现。例如 的因数对是 。一个因数往上增大,与它配对的另一个就往下减小;到两个因数都为 时相遇。
若合数 的两个因数都大于 ,乘积就会大于 ,矛盾。因此只要没有找到 至 的因数,就能判为质数。平方数的相遇点必须检查,循环上界不能漏掉等号。
bool prime(int x)
{
    if (x < 2)
    {
        return false;
    }
    for (int d = 2; d <= x / d; d++)
    {
        if (x % d == 0)
        {
            return false;
        }
    }
    return true;
}
一次试除需要 时间、 空间。检查 、、,分别应得到非质数、质数、非质数; 正好检验平方根处的等号。
找到因子后,把同一个因子除尽
分解 ,先反复除以 ,剩余数依次变为 ;再反复除以 ,变为 。此时剩下的 是最后一个质因子:
这里记录的不只是因子出现过,还要记录指数。每次遇到的第一个非平凡因子必为质数,否则它有更小的因子,应该早已被试到。循环只需对缩小后的剩余数继续检查;结束时若它还大于 ,说明它不含不超过自身平方根的因子,因而是质数。
下面用短记录 pair 保存“质因子、指数”;因子种类由输入决定,用动态列表返回。要求 ,最坏约试到 。
vector<pair<long long, int>> factor(long long x)
{
    vector<pair<long long, int>> a;
    for (long long p = 2; p <= x / p; p++)
    {
        if (x % p != 0)
        {
            continue;
        }
        int c = 0;
        while (x % p == 0)
        {
            x /= p;
            c++;
        }
        a.push_back({p, c});
    }
    if (x > 1)
    {
        a.push_back({x, 1});
    }
    return a;
}
输入为 时没有质因子,返回空列表。最坏时间为 ,这里 指原输入;记录空间不超过 ,因为每除去一个质因子,剩余数至少缩小一半。
根式中的成对因子
这部分需要先理解平方与非负平方根:,所以 。不要求先掌握复杂根式运算。
,其中一对 和一对 可以分别组成平方,故
一个质因子有 个时,每两个组成一对,根号外得到 个,根号内剩 个。下面把结果写成程序字符串;例如 6*sqrt(2) 是输出格式,正文数学关系仍写作 。
string root(long long n)
{
    long long a = 1, b = 1;
    for (auto [p, e] : factor(n))
    {
        for (int i = 0; i < e / 2; i++)
        {
            a *= p;
        }
        if (e % 2 == 1)
        {
            b *= p;
        }
    }
    if (b == 1)
    {
        return to_string(a);
    }
    if (a == 1)
    {
        return "sqrt(" + to_string(b) + ")";
    }
    return to_string(a) + "*sqrt(" + to_string(b) + ")";
}
复用前面的分解函数,范围仍为 。输入 输出 1,完全平方数只输出整数;不需要先用浮点数求近似平方根,再猜整数因子。
7. 筛法:一次处理一段范围
埃氏筛先找出重复的因子工作
如果只判断一个数,试除已经足够;若要判断 至 的每个数,逐个试除会反复检查“是否是 2 的倍数”“是否是 3 的倍数”。可以把顺序调过来:找到一个质数,就标记它的一批倍数。
在 至 的表中,先保留 ,划去 ;下一个未划掉的是 ,划去它的倍数;然后跳过已经划掉的 ,处理 。
处理质数 时,从 开始即可。更小的倍数 中 , 至少有一个小于 的质因子,所以这个数已经被前面的质数划掉。对于 , 都已处理,新的起点就是 。
以下给出完整建表过程,要求 。vis[x] 表示已经划掉,查询质数时仍需检查 x >= 2。
const int N = 1000000 + 10;
bool vis[N];

void sieve(int n)
{
    fill(vis, vis + n + 1, false);
    for (int p = 2; p <= n / p; p++)
    {
        if (vis[p])
        {
            continue;
        }
        for (int x = p * p; x <= n; x += p)
        {
            vis[x] = true;
        }
    }
}
每个合数都至少被其一个不超过平方根的质因子划到,质数则不会被别的数的倍数枚举误划。空间为 ;按质数倍数总次数估算,埃氏筛时间为 。初学时先掌握标记依据,不需要为使用它先证明质数倒数和的渐近结果。
线性筛让每个合数只由一个因子负责
埃氏筛仍可能重复划去某些数,例如 同时是 的倍数。线性筛要求每个合数只由它的最小质因子生成。把合数写成 ,其中 是这个合数的最小质因子。
| 合数 | 负责生成的 | 使用的最小质因子 |
|---|---|---|
处理 时,先用 生成 ,随后就应停止;若继续用 生成 ,其最小质因子其实为 ,会与处理 时重复。一般地,质数按升序枚举,当 第一次整除 时,它就是 的最小质因子。再往后的质数都不该与这个 配对生成合数。
const int N = 1000000 + 10;
int p[N], tot;
bool vis[N];

void sieve(int n)
{
    fill(vis, vis + n + 1, false);
    tot = 0;
    for (int i = 2; i <= n; i++)
    {
        if (!vis[i])
        {
            p[++tot] = i;
        }
        for (int j = 1; j <= tot && p[j] <= n / i; j++)
        {
            vis[i * p[j]] = true;
            if (i % p[j] == 0)
            {
                break;
            }
        }
    }
}
每个合数 的最小质因子 唯一,剩余因子 也唯一。这个 没有小于 的质因子,所以循环不会在生成 前停止;生成之后又不会由更大的质因子重复负责。标记总次数为 ,数组空间为 。这两份筛法是独立实现,不放进同一个程序;返回的标记同样不能把 当作质数。
若问题要数“满足额外性质的质数”,应先把完整条件变成每个数的真/假标记,再对标记做前缀计数。第四章的频次前缀告诉的是怎样累计;这里还需要先确定累计的究竟是什么。
8. 余数与计数:先弄清保留了哪些信息
取余保留的是分组后的剩余量
把 个物品每 个装一组,能装三组,还剩两个,写成 。模数 下的标准余数是 ,用 表示。
例如 按 分组,已经完整的组数不影响最后余数,因此可先只加两个余数 ,再取余,得到 。乘法也一样:把两数各写成“整组加余数”,展开后,含模数因子的项仍是整组,只有两个余数的乘积影响最终剩余量。
乘积仍发生在 % 之前,不能靠取余修复已经溢出的乘法。若两个余数都小于 ,用 long long 先乘可以容纳乘积;若模数再大,需要重新分析。
减法需要特别处理符号。标准余数应在 ,但 C++ 中 -2 % 5 是 -2。对两个已经位于 的余数 ,差在 内,可先令 r = (a-b) % M,仅当 r < 0 时再加 M。例如 ,补一次 得 ; 已经合法,不能再无条件加 。
普通整数除法不具有上面两条同样的规则。例如 按 取余得到 ,但先把 化为余数 再做整数除法,得到的是 。模意义下的除法需要额外条件和方法,不在这里用普通 / 替代。
分类相加,逐步选择相乘
先看两类互斥情况:一份套餐选米饭或面条,米饭有三种,面条有两种。每份只选一类,五种结果不重叠,所以相加得 。
再看连续两步:选一件两种颜色之一的上衣,再选一条三种颜色之一的裤子,每种上衣都可以配三条裤子,共 种。画成两层选择树,每个第一步分支都有三种延续。
相加要求分类互斥且覆盖所有结果;相乘要求每个阶段的延续数已正确计算。若某种上衣只能配一条裤子,另一个能配三条,就应分情况相加为 ,不能仍套 。
组合数从“选不选最后一个”递推
从 个不同元素里选 个、不区分顺序,方案数记作 。对最后一个元素分类:选它,前面还选 个;不选它,前面仍选 个。
例如从 选两个:含 的是 ,不含 的是 。两类不会重复,合起来正好六种。
图左侧的 由上一行两个 相加得到。先确定两类方案,再把它们写成表格依赖;这与第十二章“按最后一次选择划分状态”的做法一致。
以下建到 ,所有结果对 取模。未使用的格子初始为零。
const int N = 2000 + 10, mod = 1000000007;
int c[N][N];

void build(int n)
{
    memset(c, 0, sizeof(c));
    c[0][0] = 1;
    for (int i = 1; i <= n; i++)
    {
        c[i][0] = 1;
        for (int j = 1; j <= i; j++)
        {
            c[i][j] = (c[i - 1][j - 1] + c[i - 1][j]) % mod;
        }
    }
}
c[i-1][i] 为零,所以右边界也得到 。两余数之和最多为 ,int 足够;时间和空间均为 。建表只统计不同下标选择,不会因为两个元素数值相同就合并方案。
交集要减去几次
两份名单分别有 人、 人,其中两人都在两份名单中。直接相加时,这两人各出现两次,其余人一次;每个重复者减去一次,就得到 。
图右侧把两份名单分成只在左边、同时在两边、只在右边三部分;相交区域的每个人必须最终贡献一次。对于三个集合,同时位于三者交集的人先被加三次,再被三个两两交集减三次,暂时贡献零,还须加回一次。容斥的符号来自这种逐个对象的计数,不是随意交替加减。
9. 下一排列:尽量晚地改变已有前缀
第十章已经介绍怎样列出全部排列。现在已知当前排列,只想找字典序紧接着它的那个;从最小排列重新枚举会浪费之前做过的工作。
三个元素的排列依次为 123、132、213、231、312、321。比较两种排列,先看从左到右第一个不同位置;该位置较小的排列排在前面。为了让排列增大得尽量少,应尽量保留长前缀。
以 132 为例,后缀 32 已经降序,单独重排它只能让排列变小,不能增大。必须把更前面的 1 增大;后缀里比 1 大的最小值是 2,交换得到 231。再把后缀改到最小的升序 13,便得到 213。
这里包含三个动作:找最后一个还能增大的位置,换入后缀中最小的更大值,把剩余后缀排成最小。标准库 next_permutation 完成这些动作。下面 a[1] 至 a[n] 是当前排列,连续前进 m 次;火星人保证这些操作不会越过末排列。
for (int i = 0; i < m; i++)
{
    next_permutation(a + 1, a + n + 1);
}
每次最坏需要 时间,合计 。若其他题目没有“不越界”的保证,必须检查函数返回值:末排列再前进时返回假,并把序列恢复为最小排列。含重复值的序列也可以调用,但此时遍历的是不同的值序列,不能据此统计不同下标的排列数。
10. 高精度:先约定每一位存在哪里
数值很长时,保留输入字符串
内置整数类型只能容纳有限大小的数。输入有上千位时,不能先读入 long long 再拆位,因为读入时已经装不下;应先保存字符串,然后把每个十进制数码放入数组。
从加法竖式看,计算通常从个位开始。这里让下标 存个位、下标 存十位,依此类推。 保存为 a[0]=7,a[1]=8,a[2]=5,有效长度 n=3。
图中字符串从高位写到低位,数组按下标从低位写到高位。反过来的是存储顺序,不是数值改变。长度以外的位置不属于这个整数;即使旧内存里还有数,也不能参与运算。
以下几节统一处理两个非负整数:a 的有效长度为 n,b 为 m,结果写入 c,长度为 len。这里约定单个输入不超过 位,数组容量 N=4010 足够容纳两数相乘的最多 位结果。
所有数位都在 至 ,最高有效位不能是多余的零;数值零专门保留一位 [0]。读入 0007 应规范化成 [7],读入 0000 得 [0]。规范化后才能先比长度、再从最高位比较大小。
const int N = 4010;
int a[N], b[N], c[N], n, m, len;

void read(string s, int a[], int &n)
{
    n = s.size();
    for (int i = 0; i < n; i++)
    {
        a[i] = s[n - i - 1] - '0';
    }
    while (n > 1 && a[n - 1] == 0)
    {
        n--;
    }
}

void write(int a[], int n)
{
    for (int i = n - 1; i >= 0; i--)
    {
        printf("%d", a[i]);
    }
    printf("\n");
}

int cmp()
{
    if (n != m)
    {
        return n < m ? -1 : 1;
    }
    for (int i = n - 1; i >= 0; i--)
    {
        if (a[i] != b[i])
        {
            return a[i] < b[i] ? -1 : 1;
        }
    }
    return 0;
}
read(s,a,n) 读入第一个非空数字串,read(t,b,m) 读入第二个;write(c,len) 输出结果。函数通过有效长度限定读取范围,所以不依赖无效高位是否为零。比较返回 ,分别表示第一个数较小、相等、较大。
这些辅助函数只负责表示与读写,下面每种运算都要另行推导。暂时不处理负数输入;减法产生负结果时,在非负差之前输出负号。
11. 高精度加法:本位和上一位的进位
计算 ,先把个位对齐。第二个数没有百位,那里按零参与相加。
| 当前位 | 第一个数位 | 第二个数位 | 传入进位 | 合计 | 写入位 | 传出进位 |
|---|---|---|---|---|---|---|
| 个位 | ||||||
| 十位 | ||||||
| 百位 |
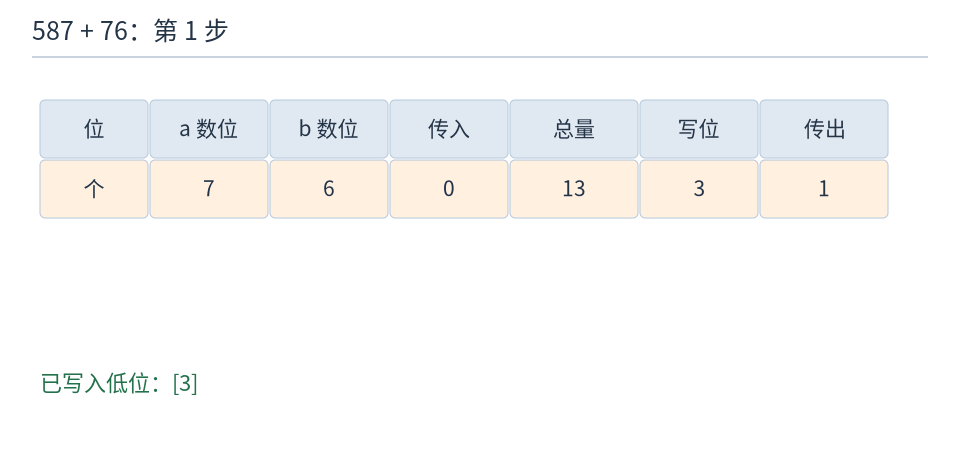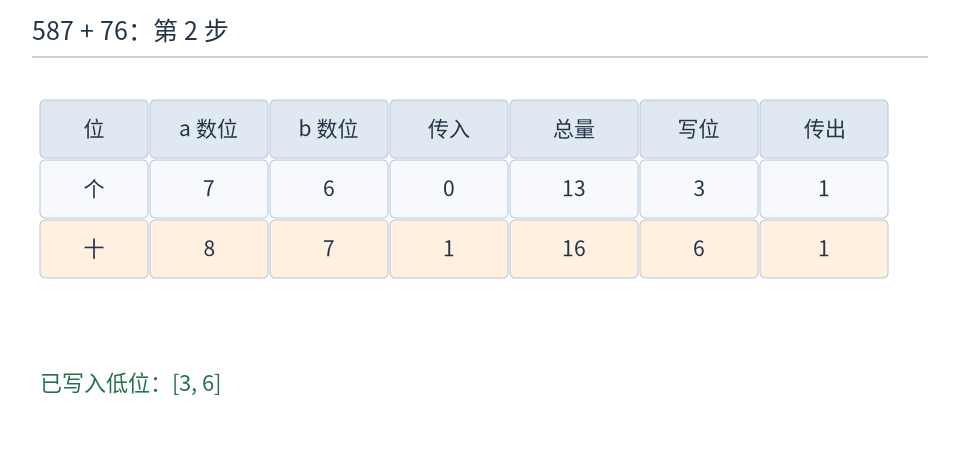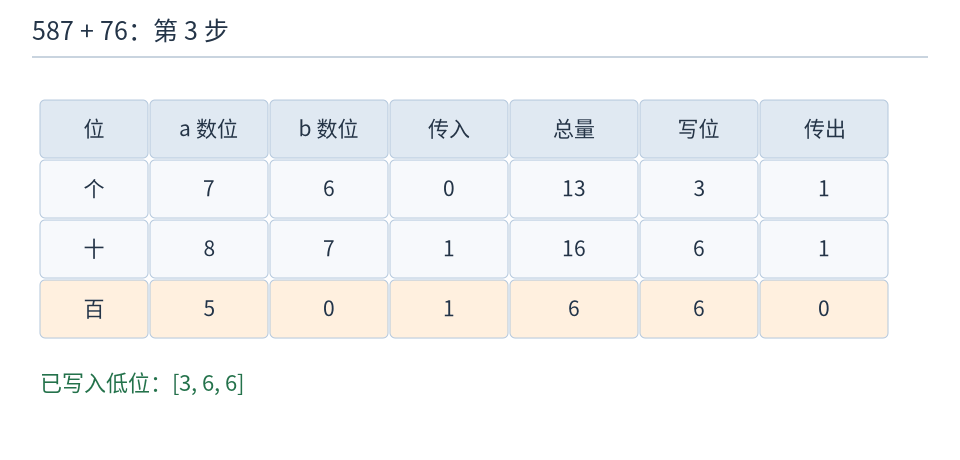
静态过程见加法竖式与三个关键步骤。动画中的亮格是正在计算的数位,传入进位和传出进位分开标记;完成低位后,其结果不会再受更高位影响。把写入位按高到低输出,就是 。
void add()
{
    len = 0;
    int t = 0;
    for (int i = 0; i < max(n, m) || t > 0; i++)
    {
        if (i < n)
        {
            t += a[i];
        }
        if (i < m)
        {
            t += b[i];
        }
        c[len++] = t % 10;
        t /= 10;
    }
}进入一轮前,t 只表示上一位进位;加上当前两个数位后,它变成本位总量;取余写位、整除后,又只保留要传给下一位的进位。循环同时检查进位,因此 999+1 最后还能写出新增的最高位 1。
输入有效长度至少为一,所以 0+0 会得到一位零。设较长输入有 位,时间与结果空间均为 ;输入每位至多 ,本位总量至多 。
12. 高精度减法:借的是下一位的一份十
先假设 。当本位不够减时,从下一位借一,等于在本位补十;下一位处理时必须扣除这次借位。计算 :
| 位 | 原数位 | 减数位 | 传入借位 | 未补十的差 | 写入位 | 传出借位 |
|---|---|---|---|---|---|---|
| 个位 | ||||||
| 十位 | ||||||
| 百位 | ||||||
| 千位 |
图里借位从低位逐次传到高位,并没有一次把所有零直接改成九。计算后数组低位在前为 [9,9,9,0],多余零在数组末尾,缩短长度后输出 。
void sub()
{
    len = n;
    int t = 0;
    for (int i = 0; i < n; i++)
    {
        int x = a[i] - t;
        if (i < m)
        {
            x -= b[i];
        }
        t = x < 0;
        if (t)
        {
            x += 10;
        }
        c[i] = x;
    }
    while (len > 1 && c[len - 1] == 0)
    {
        len--;
    }
}
函数的前提是 ,因此处理完最高位时借位已消除。两个数一样大,结果数组会被缩成一位零。
完整地输出任意两个非负输入的差,还需要比较和符号处理。先读入两个数,再执行下面的片段;交换整个数组不会把无效高位误当有效位,因为长度也随之交换。
if (cmp() < 0)
{
    swap(a, b);
    swap(n, m);
    printf("-");
}
sub();
write(c, len);
只在严格小于时输出负号,因此不会产生 -0。比较和相减均为 ;这里交换固定容量数组还需 时间,容量已按本节范围限定。若反复处理大量短数,也可以通过参数交换两组数组的角色,省去物理交换。
13. 高精度乘法:把每一项放到正确的位
长整数乘一个普通整数
计算 ,从个位起:,写 、进 ;十位是 ;百位是 ,得到 。
普通乘数可以大于九,此时进位也可能大于一。每一轮仍然只写总量的个位,把其余部分整体带给下一位。
void mul(int x)
{
    len = 0;
    long long t = 0;
    for (int i = 0; i < n || t > 0; i++)
    {
        if (i < n)
        {
            t += 1LL * a[i] * x;
        }
        c[len++] = t % 10;
        t /= 10;
    }
    while (len > 1 && c[len - 1] == 0)
    {
        len--;
    }
}
要求 。本位乘积在乘法之前提升为 long long;不能让 a[i]*x 先在 int 中溢出再赋给大类型。若旧进位小于 ,加上至多 后总量小于 ,整除十后进位又小于 ,所以这个范围可以容纳全部中间值。乘数为零时输出一位零。输入 位,普通乘数至多使长度增加十位,时间为 。
两个长整数相乘
可以展开为
数位数组的第 位代表 ,另一数第 位代表 。两项相乘,位权是 ,所以贡献加到结果第 位。
图中 放到个位, 和 都放到十位, 放到百位。未进位系数是 [8,10,3];十位的十再进一到百位,得到 [8,0,4],即 。
下面先累积所有数位乘积,再统一进位。当前代码使用本章两个输入各不超过 位的限制。
void mul()
{
    len = n + m;
    fill(c, c + len, 0);
    for (int i = 0; i < n; i++)
    {
        for (int j = 0; j < m; j++)
        {
            c[i + j] += a[i] * b[j];
        }
    }
    for (int i = 0; i + 1 < len; i++)
    {
        c[i + 1] += c[i] / 10;
        c[i] %= 10;
    }
    while (len > 1 && c[len - 1] == 0)
    {
        len--;
    }
}
某一列最多汇集 个至多为 的乘积;加上前一列的进位,总量仍小于 ,int 足够。两数乘积小于 ,预留 n+m 位足够;最后一位不会再产生容量之外的进位。时间为 ,结果空间为 。若增大位数上界,应重新检查每列累计量,不能只沿用“单个数位很小”的理由。
14. 高精度除法:从高位传来的是余数
加减乘从低位开始,是因为进位或借位传向高位。长除法反过来:先看最高位,把此前没有除尽的部分与下一位合起来。
例如 :
| 读到的数位 | 旧余数 | 临时被除数 | 当前商位 | 新余数 |
|---|---|---|---|---|
得到的商位是 0201。第一个零表示商还没到这一位,可以删去;中间的零表示十位确实为零,不能跳过,否则会把 错写成 。被除数仍以低位在前保存,只是遍历从数组末尾开始。
long long divi(int x)
{
    len = n;
    long long r = 0;
    for (int i = n - 1; i >= 0; i--)
    {
        r = r * 10 + a[i];
        c[i] = r / x;
        r %= x;
    }
    while (len > 1 && c[len - 1] == 0)
    {
        len--;
    }
    return r;
}
要求 ,除数不能为零。每轮开始的余数满足 ,接一位后临时值最多 ,所以商位至多为 ;临时值可能超过 int,故用 long long。调用后的 c 保存商,返回值是最终余数。商为零时仍输出一位 0;输入 位,时间与结果空间均为 。
15. 阶乘之和:把已经算好的结果接着用
阶乘记作 。阶乘之和要求计算 ,其中 。后面的阶乘会超出内置整数范围。
若每一项都从一重新连乘,会反复计算相同的前缀。保留上一项阶乘,乘当前 就得到新阶乘,再加到总和中。
| 旧阶乘 | 乘以 后 | 加入后的总和 | |
|---|---|---|---|
复用本章数组约定:a 保存当前阶乘,b 保存总和。mul 和 add 都把结果放入 c,因此每次要把有效结果复制回对应数组,并同时更新长度。
void solve(int x)
{
    a[0] = 1;
    b[0] = 0;
    n = m = 1;
    for (int i = 1; i <= x; i++)
    {
        mul(i);
        n = len;
        copy(c, c + len, a);
        add();
        m = len;
        copy(c, c + len, b);
    }
    write(b, m);
}循环结束一轮后,a 恰好是 ,b 恰好是前 项阶乘和。先乘后加保证包含当前项,不能只更新数组内容而忘记新长度。若最大结果长度为 ,总时间为 ,所需有效数位空间为 ;本节范围远小于已分配容量。
16. 数学表达式也要检查范围
平方根、几何和代数公式可以作为后续应用,但需要先弄清所用数学概念。这里保留几种范围检查示例,不以公式表代替一门几何或代数课程。
例如在直角三角形中,勾股关系把三条边联系起来。只比较两点距离时,可先比较距离平方,避免不必要的开方:
若坐标绝对值不超过 ,每个坐标差的绝对值至多 ,单项平方至多 ,两项相加至多 。这些值仍小于有符号 64 位上限 ;但 int 的乘法装不下平方,必须在乘法发生之前使用 long long。若坐标上界改为 ,两个最大差平方相加可达 ,这时才真正超出有符号 64 位范围。
| 进一步应用 | 先补足的数学知识 | 实现时核对 |
|---|---|---|
| 判断根的情况 | 一元二次方程与判别式 | 二次项不为零;平方、四倍乘积和相减的范围 |
| 直角三角形与勾股关系 | 哪一条是最长边;先提升类型再平方 | |
| 三角形的底与对应高 | 整数除法是否会提前丢掉半单位 | |
| 输出较小锐角的正弦 | 对边、斜边及正弦定义 | 较小锐角对应较短直角边,分数用 GCD 约分,不必先求角度 |
例如最后一项在已知正弦定义后,只需把较短直角边 与斜边 约分,输出 与 ,其中 。尚未学过相应数学概念时,先完成前面整数与数位的主线,再回来看这类应用。
练习与自查
先用小例子口述程序之外的过程:2F 怎样变成二进制;掩码 101 选了哪些下标; 为什么能换成 ;筛法为什么从平方开始; 的每次借位如何传递。能解释这些过程后,再把它们对应到代码中的循环。
本章高精度示例统一限定单个输入不超过 位;做下面的原题时,先按其位数上界重新确定数组容量,并补齐题目规定的输入输出,不能只复制运算函数。
基础练习按表示方式安排:
- 进制转换:分别检查读入、数值、输出的含义;覆盖数值零。
- 优秀的拆分:把二进制位还原成互异幂;说明奇数为什么无解。
- 质因数分解:先核对题目对质因子的要求,再决定只需找一个因子还是分解全部因子。
- 高精度加法、高精度减法:检查最后进位、连续借位、前导零和相等相减。
综合练习在对应基础后完成:
- 最大公约数和最小公倍数问题:从缩放到互质因数对,再恢复有序答案。
- 火星人:解释为什么尽量晚地改变前缀能得到下一排列。
- 阶乘之和:跟踪每轮阶乘、总和与有效长度。
- 异或和:同时检查前缀位置范围、非空区间和最早结束的选择依据。