第四章:前缀和、差分与离散化
处理数组中的一段元素时,直接从左到右计算通常最容易想到。只求一次区间和,这样做没有问题;如果题目反复询问许多区间,相同元素就可能被加上许多遍。反过来,如果题目反复给整段元素加分,直接逐个修改也会反复经过相同的位置。
这两类重复工作有不同的处理方式。区间和可以先从数组开头逐项累加,保存已经得到的结果;区间修改可以暂时不碰段内每个位置,只记下影响的开始与结束,最后再统一还原。前一种记录叫前缀和,后一种记录叫差分。本章先把它们用在一维数组上,再讨论数值范围、网格和时间区间中的相似问题。
阅读前需要掌握数组和循环;第 7 节的离散化还会用到第三章的排序。除特别说明外,数组下标从 开始。第 1 节与第 4 节给出对应例题的完整程序,其余代码用于展示局部操作;跨节同名数组不表示它们应放在同一个程序中。前缀表适合建表后保持不变的数据,差分适合多次修改后统一查看;若每次修改后都要立即查询,需要重新分析处理方法。
1. 多次查询区间和:前缀和
例题:求区间和。给定长度为 的正整数数组 ,有 次询问,每次给出闭区间 ,求 。本题中 ,且 。
从直接求和看重复
先用很小的数组试一试:。询问 时,直接相加得到 ;再询问 ,得到 。两个询问都经过了中间的 和 。如果继续问很多段,反复相加的位置还会更多。
对于这四个数,直接相加当然很快。问题在于规模:每次询问最坏要读 个数, 次询问最坏需要 时间。有没有一种记录,能让已经加过的数在下一次询问时继续派上用场?
保存从开头到每个位置的和
先不考虑任意区间,只把从数组开头到每个位置的和依次写下来。第一个数是 ,加上第二个数得到 ,继续加 得到 ,再加 得到 :
| 取到的位置 | |||||
|---|---|---|---|---|---|
| 第 项到第 项的和 |
表中的 表示一个数都没有取时的和。把这些数记为 ,一般地, 表示前 个数的和。由于前 个数比前 个数只多了 ,可以逐项计算:
这样的累计结果叫前缀和。现在回头求 : 包含四个数,其中第 项的 不在目标区间里;减去 ,就只剩 。
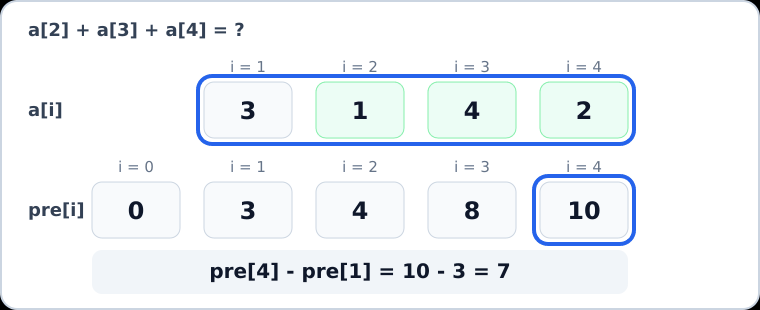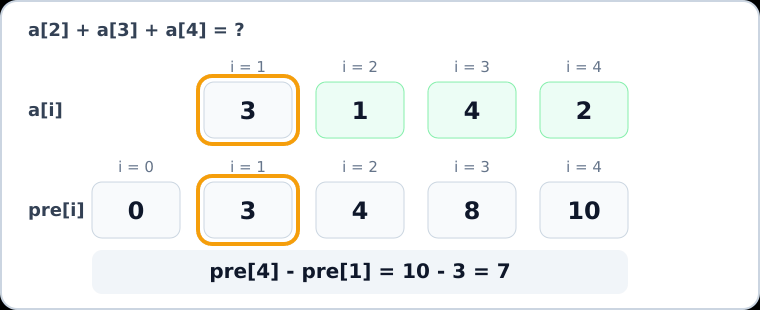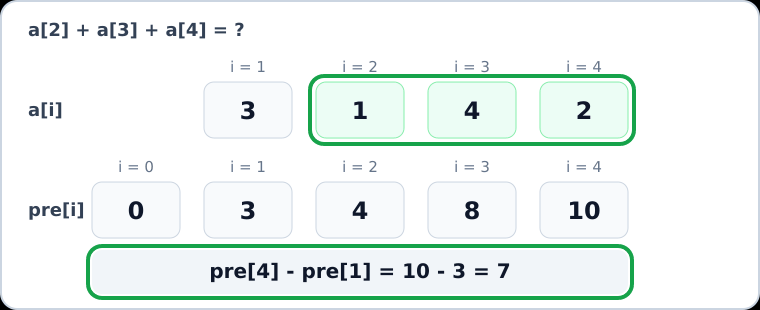
同样的方法可以换一个区间检验。求 时,取 ,减去第 项的前缀 ,得到 ,恰好等于 。求 时,左边没有要删去的数,计算 。这里 不是数组中多出来的一个元素,而是为了让从第 项开始的区间也能使用相同的减法。
把这个过程写成一般情况: 包含第 到第 项,其中第 到第 项不属于 ,它们的和是 。删去这部分后,留下的正好是目标区间:
动手代入两个容易弄错的边界。若 ,减去 ;若 ,则 ,结果只有这个位置的一个数。这两个情况都不需要单独编写查询公式。
对应到代码
程序用数组 保存上述 。下面是《求区间和》的完整实现:先读入 和数组元素,再读入询问数 及各组端点。建表时只需当前输入值,不必另存原数组;全局数组 的零号元素初始为 。
#include <bits/stdc++.h>
using namespace std;
const int N=100000+10;
int pre[N];
int main(){
    int n,q,x,l,r;
    cin>>n;
    for(int i=1;i<=n;++i){
        cin>>x;
        pre[i]=pre[i-1]+x;
    }
    cin>>q;
    while(q--){
        cin>>l>>r;
        cout<<pre[r]-pre[l-1]<<'\n';
    }
    return 0;
}
代码中的第 轮正好对应手算表格的第 列:用前一列的累计结果加上当前元素。建表要访问每个元素一次,耗时 ;此后每次查询只读两个前缀值,耗时 ,所以 次询问总耗时 ,额外空间为 。本题全部元素之和最多为 ,用 保存前缀和足够;换成数值范围更大的题目时,应重新检查整数类型。
前缀和的减法并不要求元素为正。例如数组 的前缀和依次为 。区间 的和是 ,与直接计算 相同。不过,若原数组在查询之间发生修改,它后面的前缀值也会改变;本节的方法适用于建表后数组保持不变的多次查询。
2. 多次修改区间:差分
现在换一个任务。语文成绩 给出 名学生的初始成绩,接着进行 次加分操作,每次给编号 到 的学生都加 分。全部操作完成后,求最低成绩。题目中的 可达 ,,初始成绩与单次加分都不超过 。
逐次修改区间中的每个数,最坏需要 次更新。前缀和解决的是反复求和,这里需要换一个观察角度。先看五个位置全为 的简单情况:给位置 到 都加 ,结果是 。从左往右看,影响在位置 开始,在位置 结束;位置 、 并没有出现新的变化。
如果只记“位置 开始增加 ,位置 停止增加 ”,最后从左到右累计,也能还原出 。这就是差分数组要保存的信息。对于本来就有数值的数组,还要记录每个位置相对前一个位置原本发生了多少变化。
变化只发生在区间两侧。左端的元素增加了,它与前一个元素的差会增加;右端后面的元素没有增加,它与前一个元素的差会减少。因此可以只记录影响从哪里开始、在哪里结束。
定义 ,对于 ,定义 。数组 的差分是 。把第 到第 项都加 时,原数组应变成 。对照修改前后:
- 第 项开始受到影响,所以 加 ;
- 第 项之后影响结束,所以 减 ;
- 区间内部相邻两项同时加 ,差分不变。
修改后的差分是 。从左到右累加它,依次得到 ,正好是修改后的数组。
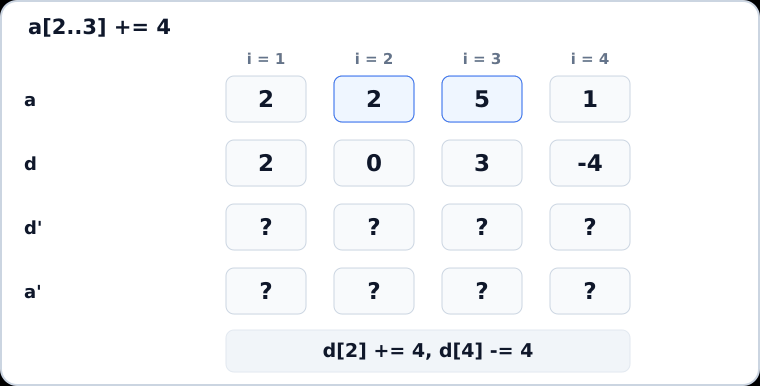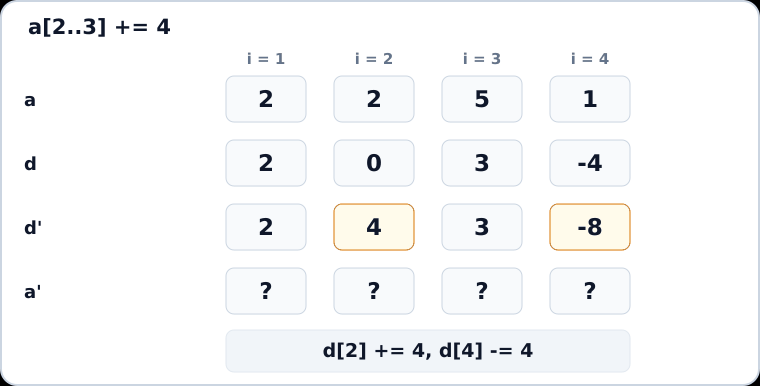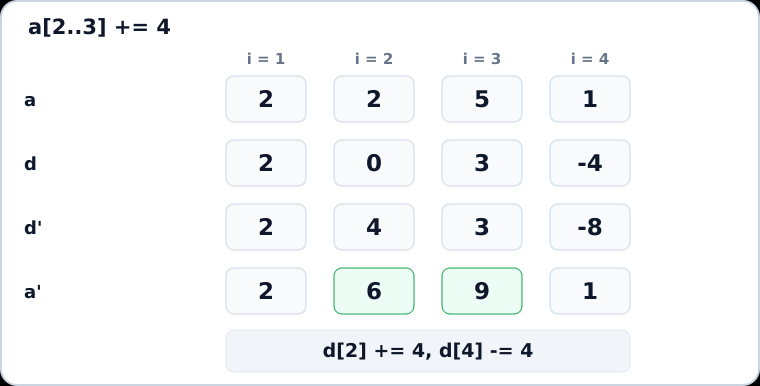
图中四行依次是原数组、原差分、修改后的差分和还原后的数组。第二项的差分加 ,影响便从第二项开始;第四项的差分减 ,影响便在第四项之前结束。第三项的差分保持 ,不是漏改,而是因为它与前一项都增加了 。
把两个端点写成一般情况,对于闭区间 ,一次操作只需
以下假设 至 已读入。数组 要覆盖下标 至 ,因为修改区间可能一直延伸到第 项,撤销标记就会落在 。本题最终单人成绩不超过 ,用 可以保存;若使用全局 数组 ,各开至少 个元素,两个数组约占 MB,仍要核对题目的内存限制。
d[1]=a[1];
for(int i=2;i<=n;++i)d[i]=a[i]-a[i-1];
d[n+1]=0;

// 每读到一次修改 l、r、x,就记录两个边界
d[l]+=x;
d[r+1]-=x;

// 全部修改结束后再还原
a[0]=0;
for(int i=1;i<=n;++i)a[i]=a[i-1]+d[i];
还原能够成立,是因为 中间的相邻项会抵消,最后得到 。一次区间操作的增量也从 开始进入累计值,到 被撤销,因此恰好只影响 。
构造和还原各扫描一次数组,全部操作总耗时 ,额外空间 。本题只求最终最低成绩,可以在还原数组的循环中顺便维护最小值;不必等全部还原后再扫描一遍。如果每次修改后都立即还原整张数组,就失去了批量处理的优势。
前缀和把经过的值累积起来,差分把一段影响拆成边界变化。此时可以先用同一组小数据手算一次查询和一次修改:求 的区间和,再给 加 并还原。两步分别需要 和 ,但它们承担的作用并不相同。
3. 按数值统计:频次前缀
前缀和的下标不一定表示数组位置。如果问题改成“有多少个元素的数值落在 ”,下标就可以表示数值。例如 中,数值落在 的元素有两个,都是 ;这与第 到第 个位置无关。
设所有数值都是 至 的整数。先用 记录数值 出现了几次,再令 表示“不大于 的元素共有几个”。这仍然是前缀和,只是累计对象从原数组的元素,变成了各数值的出现次数。
以 为例,;逐项累加频次后,,对应数值 。数值落在 的个数,等于不大于 的个数减去小于 的个数,即 。边界与位置前缀和相同:减去的是下界之前的部分。
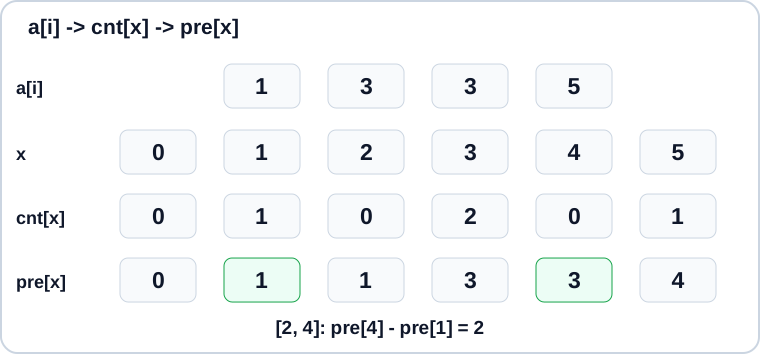
图中第一行按输入位置排列;下面三行的列由数值 决定。数值 在原数组中出现两次,所以 ;累加到数值 ,一共见到三个元素,所以 。以下假设 和 都能覆盖下标 至 ,且初始为零。
for(int i=1;i<=n;++i)++cnt[a[i]];
pre[0]=cnt[0];
for(int x=1;x<=V;++x)pre[x]=pre[x-1]+cnt[x];

// 对数值区间 [L,R] 查询,保证 0 <= L <= R <= V
int ans=pre[R]-(L==0?0:pre[L-1]);
每个输入数只增加一次对应频次,所以没有遗漏,也不会把某个元素计两次。若 ,下界之前没有任何非负数值,直接取 ,不能访问 。建表耗时 ,每次查询 。
当 特别大时,不能只因为 小就按原数值开数组。第 7 节会介绍如何只给出现过的数值编号;若还要回答任意数值区间的计数询问,查询边界也必须能对应到这些编号,不能直接拿原来的 当下标。
4. 网格中的矩形和:二维前缀和
例题:领地选择。给定 行 列的价值地图,要找出和最大的、边长为 的正方形区域,其中 ,每个格子的价值绝对值不超过 。
最直接的办法是枚举每个候选正方形,再扫描它覆盖的所有格子。但相邻正方形通常有大片重叠区域,每次重新求和会反复读取这些格子。先把从左上角开始的矩形和保存下来,就可以用几次加减得到任意位置的矩形和。
定义 为第 至第 行、第 至第 列组成的矩形和;第 行和第 列的前缀值均为 。它们表示空矩形,不占据真实格子。
先用下面的 矩阵手算:
1 2 3
4 5 6
7 8 9
要求第 至第 行、第 至第 列,直接读格子得到 。接着尝试只用从左上角开始的矩形和得到同一个答案。
整个 矩形的和是 。先减去目标矩形上方的第一行,和值为 ;再减去左方的第一列,和值为 。但是左上角的 同时属于第一行和第一列,刚才被减去了两次,而它原来只被计入整个矩形一次。因此要把它补回:。
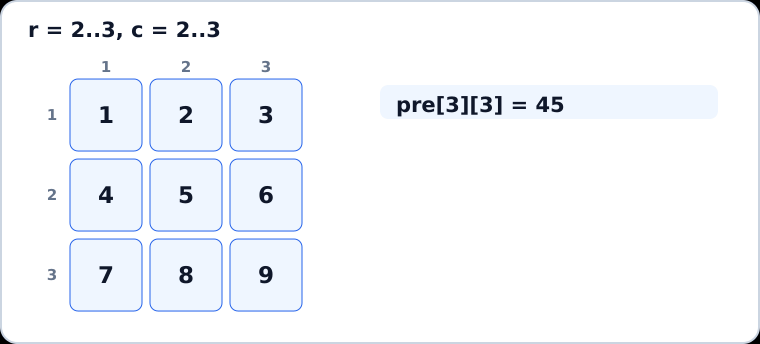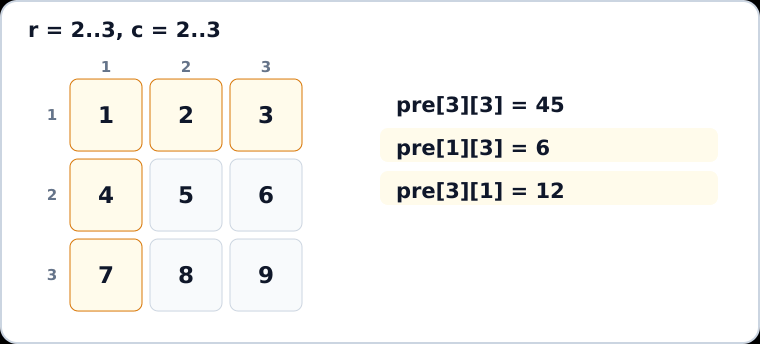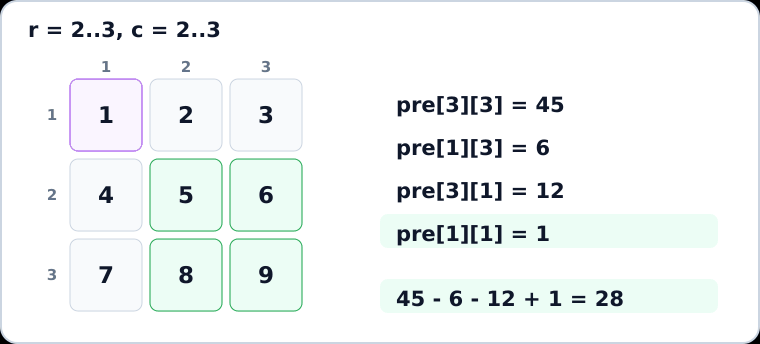
图中依次显示完整前缀矩形、需要排除的上方与左方、以及补回交集后留下的目标区域。任意矩形都按同一方法处理。设目标矩形左上角为 、右下角为 ,则
查询公式确定后,还要建立前缀表。求 时,可以把“当前格子上方的前缀矩形”与“左方的前缀矩形”相加,再加上当前格子。上方与左方的交集被计入两次,所以必须减去一次。
仍看小矩阵的左上角 区域:上方的和是 ,左方的和是 ,交集是 ,当前格子是 。于是 ,与逐格相加相同。代码中的四项正好对应这四块区域。
for(int i=1;i<=n;++i){
    for(int j=1;j<=m;++j){
        pre[i][j]=pre[i-1][j]+pre[i][j-1]-pre[i-1][j-1]+a[i][j];
    }
}

// 对合法矩形 (x1,y1) 至 (x2,y2) 查询
long long ans=pre[x2][y2]-pre[x1-1][y2]-pre[x2][y1-1]+pre[x1-1][y1-1];
本题整张矩阵的和在极端情况下可能超过 ,所以 应使用 ;输入格子的值仍可用 。数组要覆盖第 行和第 列,它们初始为零。对于最大 的地图,两个方向的下标都至少需要 至 。
前缀表建好后,枚举每个能放下边长 的正方形,用上述查询式得到它的和,再更新当前最大值及其左上角位置。由于格子可能为负,最大值从左上角为 的真实正方形开始,不能把 当成默认可行答案。下面是《领地选择》的完整实现,输出最优正方形左上角的行、列坐标。原题保证最优解唯一。
#include <bits/stdc++.h>
using namespace std;
const int N=1000+10;
long long pre[N][N];
int main(){
    int n,m,c,a;
    cin>>n>>m>>c;
    for(int i=1;i<=n;++i){
        for(int j=1;j<=m;++j){
            scanf("%d",&a);
            pre[i][j]=pre[i-1][j]+pre[i][j-1]-pre[i-1][j-1]+a;
        }
    }
    long long best=pre[c][c];
    int bx=1,by=1;
    for(int x=1;x+c-1<=n;++x){
        for(int y=1;y+c-1<=m;++y){
            int x2=x+c-1,y2=y+c-1;
            long long sum=pre[x2][y2]-pre[x-1][y2]-pre[x2][y-1]+pre[x-1][y-1];
            if(sum>best){
                best=sum;
                bx=x;
                by=y;
            }
        }
    }
    cout<<bx<<' '<<by<<'\n';
    return 0;
}
建表与枚举各需 时间,每个候选区域的求和是 ;前缀表占 空间。
5. 差分下标表示位置还是边
校门外的树 中,位置 到 各有一棵树,若干闭区间内的树将被移走,求剩余数量。第一章使用逐位置标记已经能够解决这道题。这里换用差分,是为了看清“位置”和“边”作为统计对象时端点如何变化。
对于移走树的闭区间 ,差分标记在 加 、在 减 。从位置 开始累计覆盖次数;次数为 的位置仍有树,次数大于 的位置只移走一次。即使几段区间重叠,也不会重复扣除同一棵树。
本题 ,差分数组需要覆盖下标 至 。逐段修改每个位置最坏要花 时间;记录边界后只需 时间,其中 为区间数量。
如果统计的是从站点 走到站点 经过的边,按每条边的较小端点编号,经过的是边 ,即闭区间 。因此在 开始、在 撤销。
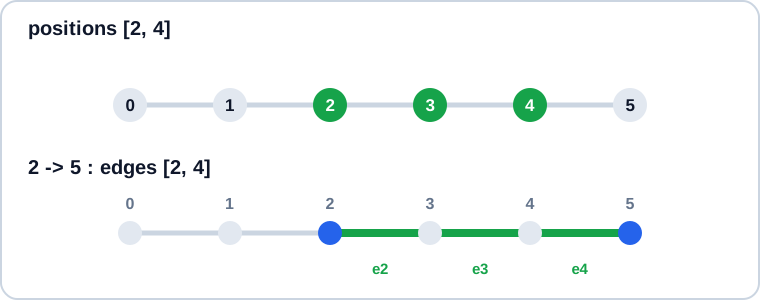
上排绿色标记落在站点上,下排绿色标记落在两个站点之间。两种任务都能用差分,但先要决定下标代表树的位置还是路段的边;如果把下排路径误当成站点闭区间 ,就会多算一个对象。
6. 多次修改矩形:二维差分
例题:地毯。在 的方格中放置 个矩形地毯,最后输出每个格子被多少块地毯覆盖。题目中 ,每块地毯覆盖的行、列范围都是闭区间。
如果放置一块地毯时逐格增加覆盖次数,一次操作就要访问矩形面积数量的格子。前面的一维差分已经表明,整段加一可以只记“开始”和“结束”。二维矩形有行、列两个方向,沿两个方向各记录一次开始与结束,会得到四个角。先允许每块矩形增加一般的数值 ,本题再取 。
例如在 的零矩阵中,只给第 至 行、第 至 列加 。先在 开启影响;越过第 行时,在 取消;越过第 列时,在 取消。右下外侧的 被取消两次,需要补回一次。
四个角的标记依次是 加 、 减 、 减 、 加 。把标记向右、向下累加,还原后应得到:
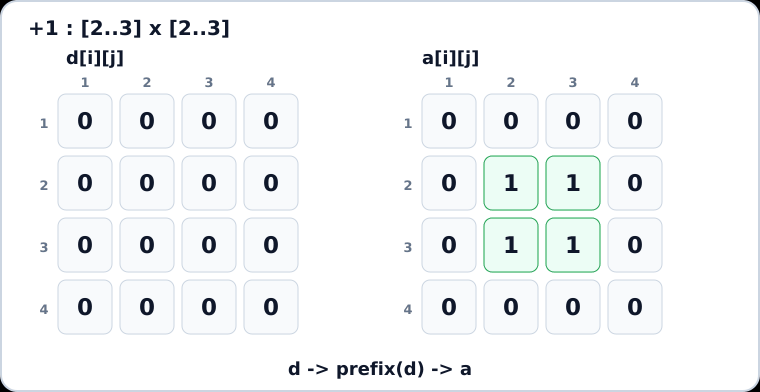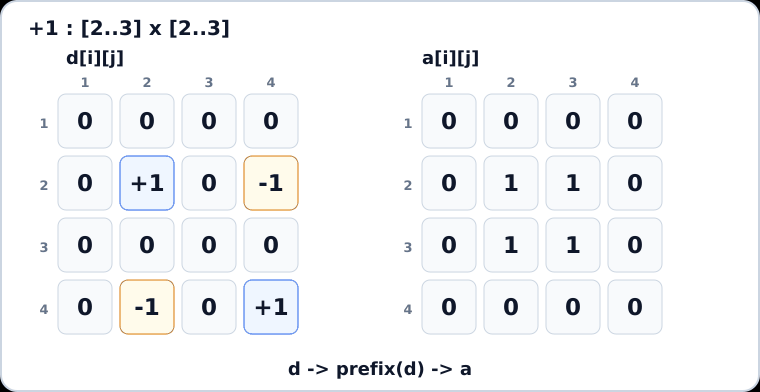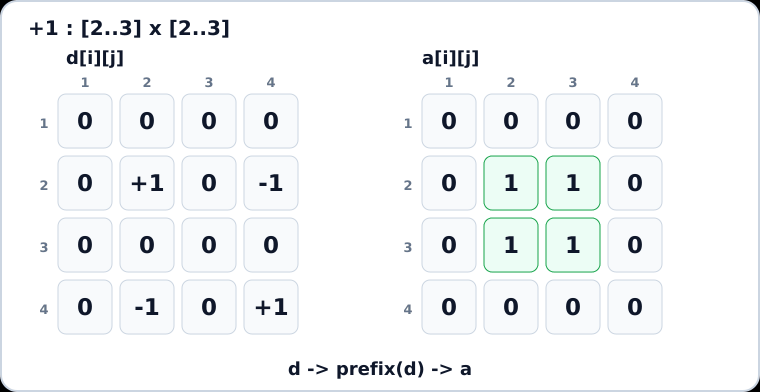
左图是差分标记,右图是还原后的方格。比如格子 的左上方只包含 的 ,所以最后为 。格子 的左上方包含四个标记,合计 ;右下角的 正是为了抵消两次撤销造成的多减。
使用全零的二维数组 存标记。地毯可能贴到方格的最下边或最右边,因此数组两维都要留出下标 。每次修改先执行四处更新;全部操作结束后,从左上到右下做二维前缀和。
还原到位置 时,它左边、上边及左上方的格子已经还原;当前位置的 仍是原来的角标记。像二维前缀和一样,取上方与左方的累计值,减去重复的左上部分,再加当前位置的标记,就得到这个格子的最终增量:
d[x1][y1]+=v;
d[x2+1][y1]-=v;
d[x1][y2+1]-=v;
d[x2+1][y2+1]+=v;

for(int i=1;i<=n;++i){
    for(int j=1;j<=n;++j){
        d[i][j]+=d[i-1][j]+d[i][j-1]-d[i-1][j-1];
    }
}
还原后的 就是位置 收到的全部增量。如果原矩阵并非全零,再把增量加回原值;不要把原值和差分标记混在同一个含义不明的数组中。
《地毯》每次修改取 ,单个格子的覆盖次数最多为 ,使用 足够。 表示地毯数量,不能把它误当成列数。四角更新每块地毯花 时间,最后还原花 时间,总时间为 ,空间为 。
一维和二维的方法都离不开下标的含义。遇到新题,先确定下标代表数组位置、数值、格子还是边,再决定怎样累计、在哪里撤销影响。
7. 坐标很大时:离散化
考虑一个坐标排名问题:给出 个整数,将出现过的不同数从小到大依次编号为 ,最后按输入顺序输出每个数的编号。相同整数必须得到相同编号。设 ,每个整数可能在 至 之间。
如果直接按数值开数组,即使只有几个输入数,也可能需要为数十亿个没有出现的整数预留位置。这里真正要保留的是数值之间的大小顺序,而非它们之间的每个空位置。这种把出现过的坐标压缩成连续编号的方法叫离散化。
例如输入 。把出现过的不同数排成 ,分别编号为 。再回到原输入顺序,依次得到 。两个 必须得到相同编号,而第 个输入数虽然在排序后排到最前面,输出时仍应回到第 个位置。
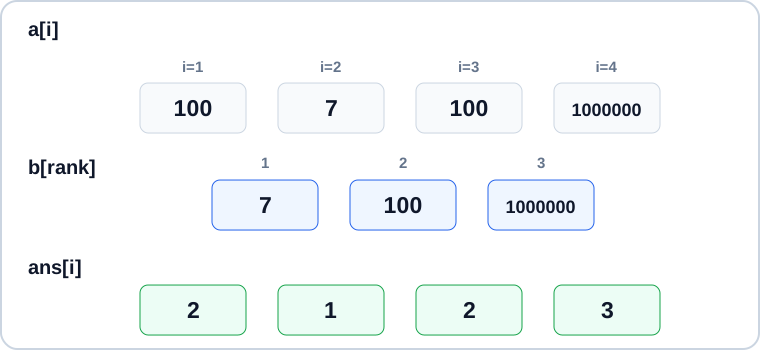
图中中间一行只保留了三个不同数值;最下面一行仍有四个编号,因为输出要与四个输入位置一一对应。排序时若只留下数值、不记录原位置,就无法确定每个编号应写回哪里。
第三章已经学习按结构体字段排序。把每个原值与它的输入位置放在同一条记录里,排序时两项信息便会一起移动。排序后相同数排在一起,扫描时只有遇到新值才增加编号。最后借助记录的原位置,把编号写回答案数组。
下面 保存去重后的值, 保存原位置 的编号;数组容量按本题上界分配,假设 已读入。
struct Item{
    int x,id;
};
const int N=200000+10;
Item a[N];
int b[N],ans[N];
bool cmp(const Item &u,const Item &v){
    return u.x<v.x;
}

// 以下读入和扫描语句放在 main 中
for(int i=1;i<=n;++i){
    cin>>a[i].x;
    a[i].id=i;
}
sort(a+1,a+n+1,cmp);
int m=0;
for(int i=1;i<=n;++i){
    if(i==1||a[i].x!=a[i-1].x)b[++m]=a[i].x;
    ans[a[i].id]=m;
}
相同值在排序后相邻,只有遇到新值才增加编号,所以相同值获得同一编号,较小值获得较小编号。 保存全部不同原值且严格递增。排序耗时 ,扫描 ,额外空间 。学完第六章的二分后,也可以在 中查找某个已有值的编号。
若题目要计算实际距离,仍应使用原坐标;例如 不能用编号差 代替。
8. 按变化的时刻处理区间:事件扫描
考虑热水供应问题:设备每分钟最多提供 单位热水。用户 在时间段 内每分钟使用 单位,热水不能储存。要判断有没有时刻的总用量超过 。在这个问题中,用户数最多 ,每个用量最多 ,时间坐标最多 。
时间段是左闭右开:在 开始使用,在 已经停止。因此这一段产生两个事件: 与 。这里直接使用题目的半开区间;一维差分中闭整数区间的 规则,不能照搬到 上。
例如有两名用户分别在 使用 单位、在 使用 单位。时刻 ,前一人已停止、后一人刚开始,总用量是 ,不是 。若两个事件出现在同一时刻,必须把这一时刻的变化全部处理完,再判断接下来这一段时间的用量。
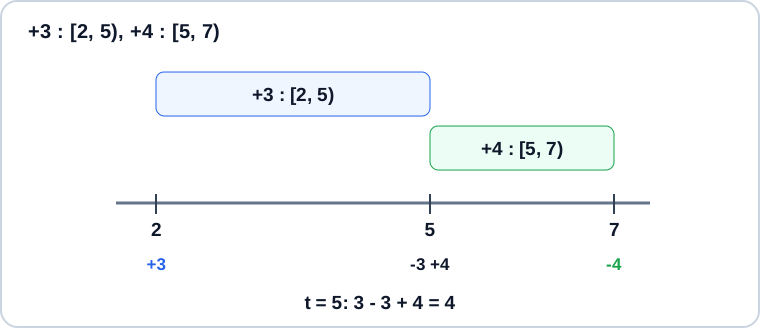
图中的两段在时刻 相接,但没有重叠。先把结束事件 和开始事件 都计入,才能得到时刻 之后的用量 ;如果只处理其中一个事件就立即检查,可能得到一个并不存在的中间用量。
当时间坐标范围很小时,可以直接开差分数组:令 、,再按时间从小到大累加。
如果时间坐标很大,而用户只有少量,开一个覆盖全部时间的数组就会浪费空间。总用量只在某个用户开始或结束时改变,因此只保存这些事件,按时刻排序后依次处理即可。
这道题本身的时间坐标范围不大,直接开差分数组即可。事件排序展示的是同一想法在坐标范围很大时怎样继续使用,而不要求为每个空时刻分配空间。
下面的 容量至少为 ,元素类型为 , 初始为 。每读入一名用户,执行前两行;全部读完后统一排序扫描。最多 名用户的用量相加可能达到 ,所以事件增量与当前用量使用 。
ev[tot++]={S,P};
ev[tot++]={T,-P};

sort(ev,ev+tot);
long long cur=0;
bool ok=1;
for(int i=0;i<tot;){
    int t=ev[i].first;
    while(i<tot&&ev[i].first==t){
        cur+=ev[i].second;
        ++i;
    }
    if(cur>W)ok=0;
}
同一时刻的事件先全部相加, 才表示从该时刻开始、到下一事件时刻之前的总用量。所有用户的开始和结束都被记录,因此任意两相邻事件之间用量不会改变;检查每个事件时刻之后的值,就检查了全部可能超额的时间段。排序耗时 ,扫描 ,空间 。
如果问题接着询问“某段整数位置中,有多少位置的覆盖次数达到门槛”,可先用差分还原每个位置的覆盖次数,再把是否达标记为 或 ,最后对这些标记做前缀和。此时前缀和统计的是达标位置的数量,不是覆盖次数总和。每次变换后,数组所表示的信息都要重新说明。
离散化与事件扫描都避免为大量空坐标分配空间,但它们保存的信息不同:离散化把出现过的坐标换成顺序编号;事件扫描只在数值发生变化的时刻更新累计量。需要实际时间长度或坐标距离时,都应保留原坐标。
留言
可以匿名留言,无需注册或登录。昵称和邮箱均可不填,邮箱不会公开显示。
正在加载留言区…