第七章:递推、递归与分治
许多问题都可以从规模更小的同类问题出发。区别在于:递推先确定小规模答案,再按依赖顺序逐步扩大;递归让函数暂时等待子问题返回;分治则把一个较大的问题拆成若干部分,分别求解后再合并。
本章先用同一个走楼梯问题比较递推与递归,再从合并两个有序序列出发建立分治和归并排序。逆序对与快速幂用于说明:掌握一种结构后,更重要的是识别它还能解决哪些问题。
阅读前需要掌握数组、函数和参数传递。各个 C++ 程序均独立编译;本章用到的移位和按位与会先解释必要含义,第十三章再系统展开。
1. 从小规模答案递推到大规模答案
1.1 递推的四个组成部分
考虑下面的问题:一段楼梯共有 级,每次只能向上走 级或 级,求恰好走到第 级的方案数。
数据范围为 。
直接列举每一步走一级还是两级,会反复遇到相同的剩余楼梯。可以换一个角度,按最后一步分类:
- 最后走 级,此前必须已经到达第 级;
- 最后走 级,此前必须已经到达第 级。
两类走法互不重叠,并且覆盖了到达第 级的全部方案。令 表示到达第 级的方案数,便有
还需要确定最小规模的答案。到达第 级表示一步也不走,这是一种空方案,所以 ;到达第 级只能走一步,所以 。
从小到大计算时,求 所需的 和 都已经得到。以下用全局数组 保存各级答案。
前几个状态依次为 。例如,到达第 级的五种走法为
1+1+1+1
1+1+2
1+2+1
2+1+1
2+2
程序读入 ,输出方案数。下面也允许 ,用它检验空方案初值。
#include <bits/stdc++.h>
using namespace std;
int f[50];
int main(){
    int n;
    cin>>n;
    f[0]=f[1]=1;
    for(int i=2;i<=n;++i)f[i]=f[i-1]+f[i-2];
    cout<<f[n]<<'\n';
    return 0;
}
这个例子包含递推的四个基本部分:
- 状态: 表示什么;
- 初值:最小规模的答案是什么;
- 转移:怎样由较小状态得到当前状态;
- 顺序:计算当前状态时,它依赖的状态是否已经得到。
本题的时间复杂度为 ,数组空间为 。只求最终答案时,可以只保留相邻的两个状态,把额外空间降为 。本题中 ,可以用 保存;若继续扩大 ,需要重新检查数值范围。
2. 同一个关系也可以写成递归
2.1 让函数等待子问题返回
上一节的关系也可以直接写成函数:要求第 级的方案数,就分别求第 级和第 级的方案数,再把两者相加。
调用 时,函数不会立刻得到答案,而是继续提出更小的问题:
solve(4)
├── solve(3)
│   ├── solve(2)
│   └── solve(1)
└── solve(2)
当参数缩小到 或 时,函数可以直接返回。随后各层调用从下向上取得子问题的结果,最终得到 。
要看清“等待”,可以把每次调用想成一张记录纸:纸上写着参数和下一步要执行的位置。求 的完整过程如下,代码刻意先求左子问题、再求右子问题,固定手算顺序:
| 时刻 | 活跃调用 | 已保存的现场 | 下一步 |
|---|---|---|---|
| 等待 | 调用 | ||
| 等待 | 调用 | ||
| 命中出口,返回 | 回到 | ||
| 本层 | 调用 | ||
| 命中出口,返回 | 回到 | ||
| 本层 | 返回 | ||
| 本层 | 调用 | ||
| 命中出口,返回 | 回到 | ||
| 本层 | 返回 |
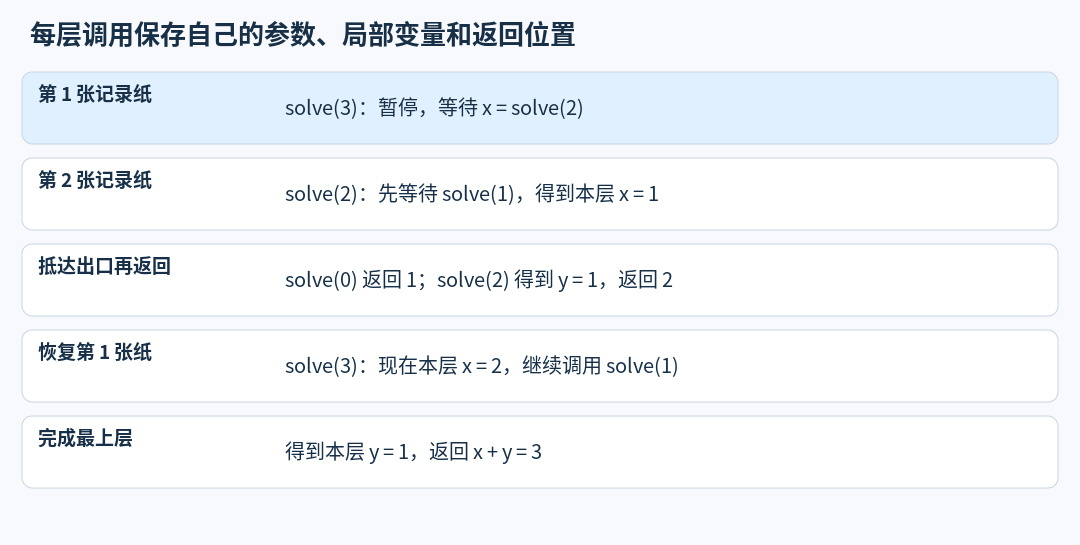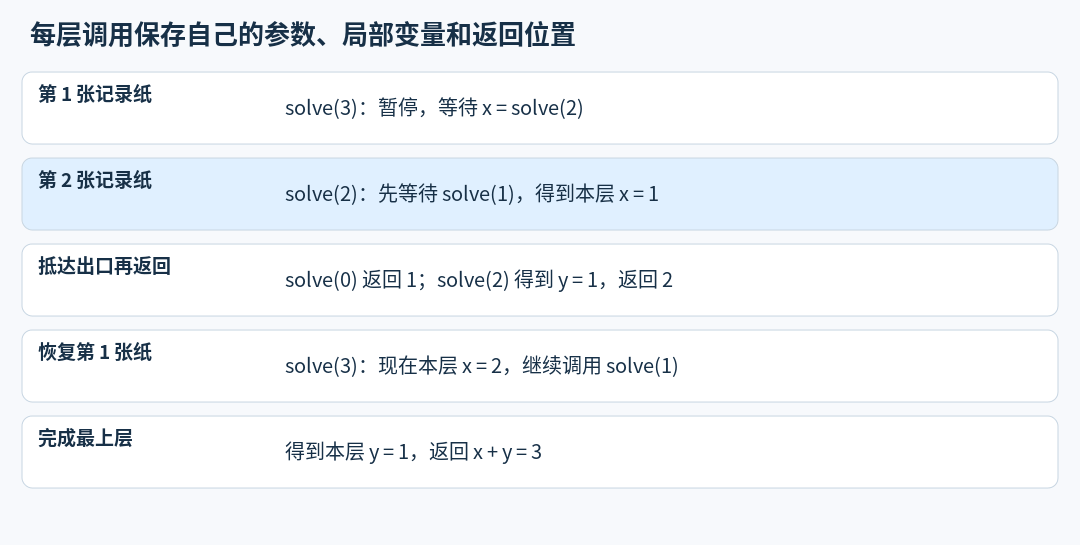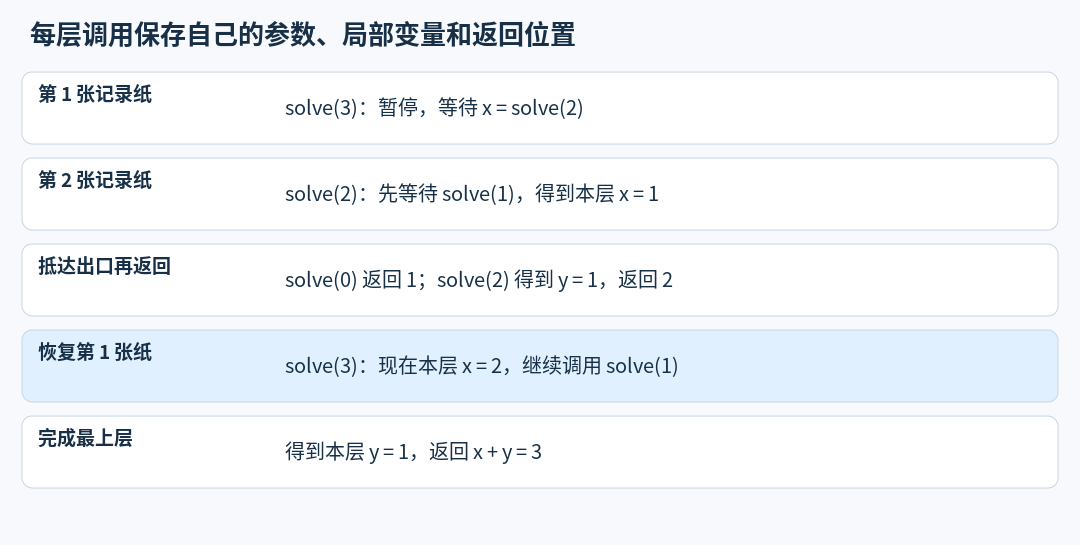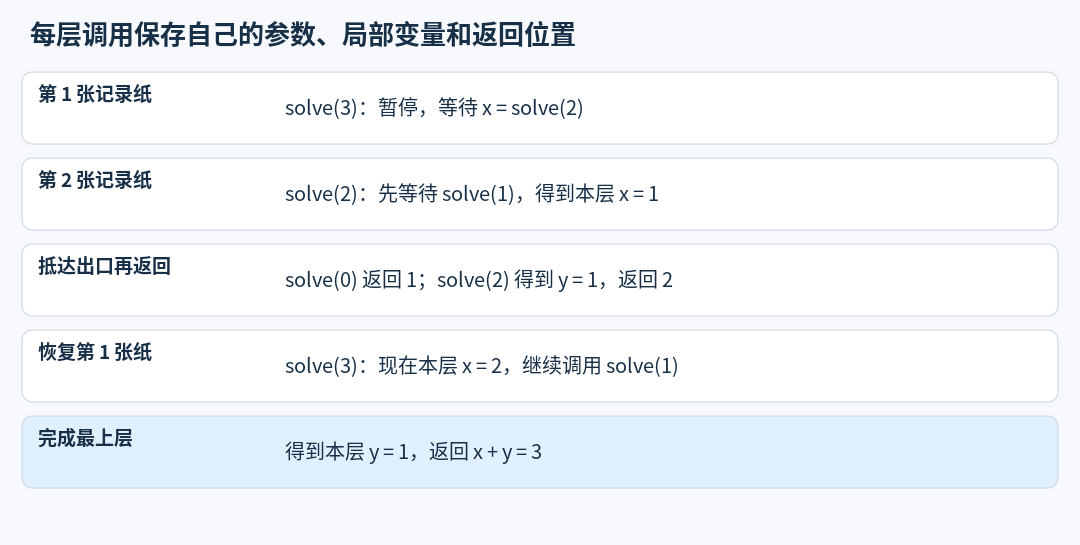
动画按执行顺序标亮当前记录;静态图 保留完整过程。
内的 不会覆盖 内的 。同名局部变量属于不同调用;而全局数组只有一份,修改后不会随函数返回自动撤销。这个区别将在第十章回溯中再次使用。
朴素递归程序只用于小规模观察,约定输入 。原问题 应使用前节递推,不能因返回类型足够大就忽略运行次数。
#include <bits/stdc++.h>
using namespace std;
int solve(int n){
    if(n==0||n==1)return 1;
    int x=solve(n-1),y=solve(n-2);
    return x+y;
}
int main(){
    int n;
    cin>>n;
    cout<<solve(n)<<'\n';
    return 0;
}
一段递归通常需要回答三个问题:
- 当前函数负责解决什么规模的问题;
- 它怎样把任务交给规模更小的同类问题;
- 哪些最小规模可以直接回答,使递归停止。
证明递归一定结束时,应找出一个每次严格减小并且存在下界的量。本例中这个量就是 。
2.2 递归表达关系,递推安排计算
递归代码与上一节的递推式表达了同一个关系,但计算过程不同。上面的调用树中, 被计算了两次;规模继续增大时,同一个参数会被反复调用,总调用数呈指数增长。递归深度虽然只有 ,工作量却远大于 。
递推把每个 只计算一次,因此更适合直接求本题答案。二者不是互相替代的两个公式,而是两种组织计算的方式:
| 比较项 | 递推 | 递归 |
|---|---|---|
| 计算方向 | 从已知的小状态推到大状态 | 从当前问题调用更小问题,再等待返回 |
| 必要条件 | 初值、转移和合法计算顺序 | 终止条件和严格缩小的问题规模 |
| 本题朴素实现 | 指数级 | |
| 常见优势 | 避免重复计算,运行过程清晰 | 代码贴近问题定义,适合描述分支与嵌套结构 |
若递归更容易描述问题,又存在重复子问题,可以保存已经算过的结果,这就是记忆化。它将在动态规划章节继续讨论。
2.3 每层调用都有自己的现场
递归函数的每次调用都会保存自己的参数、局部变量和返回位置。下层调用结束后,程序回到上层尚未完成的位置继续执行。
按值传递的参数在每层都有独立副本;全局数组和全局计数器则由所有层共同使用。修改局部参数不会改变上层保存的值,修改全局状态却不会在返回时自动恢复。这个区别是后续理解搜索与回溯的基础。
递归还会占用调用栈。线性递归若深入到 层,可能在完成计算前就发生栈溢出。分析递归时,需要分别检查递归深度和总调用数,不能把两者混为一谈。
3. 先学会合并两个有序序列
分治中的“拆分”往往容易,真正决定算法是否高效的是“合并”。在讨论归并排序前,先解决一个更具体的问题:怎样把两个已经有序的序列合成一个有序序列。
以左序列 和右序列 为例。两个序列各自有序,所以它们尚未取出的最小元素一定在各自开头。每次只需比较这两个候选,取较小者放入结果。
| 左侧候选 | 右侧候选 | 本次取出 | 当前结果 |
|---|---|---|---|
| 右侧已空 |
用两个指针分别指向两段尚未取出的第一个元素,就能在线性时间内完成合并。下面的独立程序第一行输入两个长度 ,接着输入两个非降序数组,各自长度为 至 ,元素均在 范围内。数组 分别保存两个输入, 保存已经合并的结果;输出一个合并后的有序数组。
#include <bits/stdc++.h>
using namespace std;
const int N=500000+10;
int a[N],b[N],c[2*N];
int main(){
    int n,m;
    scanf("%d%d",&n,&m);
    for(int i=1;i<=n;++i)scanf("%d",&a[i]);
    for(int i=1;i<=m;++i)scanf("%d",&b[i]);
    int i=1,j=1,k=0;
    while(i<=n&&j<=m){
        if(a[i]<=b[j])c[++k]=a[i++];
        else c[++k]=b[j++];
    }
    while(i<=n)c[++k]=a[i++];
    while(j<=m)c[++k]=b[j++];
    for(int p=1;p<=k;++p)printf("%d%c",c[p],p==k?'\n':' ');
    if(k==0)puts("");
    return 0;
}
在循环过程中, 始终保存已经取出元素的有序结果。一侧取空后,另一侧剩余元素本来就有序,按原顺序接到末尾即可。每次恰好消耗一个输入元素,所以总时间为 ,输出数组占 空间。把两个输入按“左序列在前、右序列在后”看成原序列时,相等元素先取左边,且各自内部顺序不变,这叫稳定合并。若左右都有 ,两个 都应进入结果,不能因为相等而删掉一个。
4. 分治与归并排序
4.1 把“排序”拆成三个阶段
现在回到一个无序区间。若直接合并,它的左右部分并不一定有序,上一节的方法无法使用。可以先把区间分成两半,分别排好,再合并两个有序结果:
分解:把当前区间分成左右两半
求解:分别把左右两半排好
合并:把两个有序区间合成一个有序区间
左右两半仍是排序问题,可以继续使用同样的方法;当区间只剩一个元素时,它天然有序,不必继续拆分。这就是归并排序中的分治结构。
[5, 2, 7, 1]
        ↓ 分解
[5, 2]        [7, 1]
  ↓              ↓
[5] [2]        [7] [1]
  ↓ 合并          ↓ 合并
[2, 5]        [1, 7]
        ↓ 合并
    [1, 2, 5, 7]
4.2 归并排序的核心实现
下面程序第一行输入 ,第二行输入 个 范围内整数,输出有序结果。全局数组 保存待排序序列, 是各层共用的辅助数组。调用 即可完成排序。
一次调用 的承诺是:返回时,原数组 已经排好。调用左半时,右半保持原样;左半返回后再排右半,最后才读取两个有序结果。辅助数组即使被不同层重复使用也没有冲突,因为每层合并后立即把结果写回自己的 ,上层依赖的是写回后的 。
#include <bits/stdc++.h>
using namespace std;
const int N=500000+10;
int a[N],b[N];
void merge_sort(int l,int r){
    if(l>=r)return;
    int mid=(l+r)/2;
    merge_sort(l,mid);
    merge_sort(mid+1,r);
    int i=l,j=mid+1,k=l;
    while(i<=mid&&j<=r){
        if(a[i]<=a[j])b[k++]=a[i++];
        else b[k++]=a[j++];
    }
    while(i<=mid)b[k++]=a[i++];
    while(j<=r)b[k++]=a[j++];
    for(int p=l;p<=r;++p)a[p]=b[p];
}
int main(){
    int n;
    scanf("%d",&n);
    for(int i=1;i<=n;++i)scanf("%d",&a[i]);
    merge_sort(1,n);
    for(int i=1;i<=n;++i)printf("%d%c",a[i],i==n?'\n':' ');
    return 0;
}
递归处理结束后, 和 已经分别有序。合并循环每次取两个候选中的较小值,因此写入 的部分始终有序;最后把 写回 ,上层调用才能使用这一段的排序结果。
每次把区间大致分成两半,共有 层。每一层参与合并的区间总长度为 ,工作量为 ,所以总时间复杂度为 。辅助数组需要 空间,递归调用栈还需要 空间。
不能只看到“对半递归”就直接写出 。这个结论还依赖于每层合并的总工作量为 。
5. 在归并时统计逆序对
例题:逆序对。
给定一个长度为 的序列,统计满足 且 的位置对数量。相等元素不构成逆序对。
数据范围为 ,元素是不超过 的正整数。
逐个枚举数对需要 时间。归并排序在合并左右两段时,恰好能够集中处理跨越中点的逆序对。
仍以左段 和右段 为例。第一次比较时,右侧的 小于左侧的 。由于左段已经有序, 也一定小于左侧尚未取出的 和 ,因此一次得到 个逆序对。后来右侧的 小于左侧剩余的 ,再得到 个。
一般地,合并时若 ,那么 都大于 ,新增逆序对数量为
用重复值再检查一次:左段 、右段 。右边的 贡献两对;接着左右都是 ,先取左边,不增加计数。若把比较写成严格小于,就会把相等的 错算成逆序。
下面程序输入输出与原题一致。函数同时承担两个任务:返回当前区间中的逆序对数量,并把当前区间排好。缺少排序副作用,上层就无法一次计算一批逆序对。
#include <bits/stdc++.h>
using namespace std;
const int N=500000+10;
int a[N],b[N];
long long merge_sort(int l,int r){
    if(l>=r)return 0;
    int mid=(l+r)/2;
    long long ans=merge_sort(l,mid)+merge_sort(mid+1,r);
    int i=l,j=mid+1,k=l;
    while(i<=mid&&j<=r){
        if(a[i]<=a[j])b[k++]=a[i++];
        else{
            ans+=mid-i+1;
            b[k++]=a[j++];
        }
    }
    while(i<=mid)b[k++]=a[i++];
    while(j<=r)b[k++]=a[j++];
    for(int p=l;p<=r;++p)a[p]=b[p];
    return ans;
}
int main(){
    int n;
    scanf("%d",&n);
    for(int i=1;i<=n;++i)scanf("%d",&a[i]);
    printf("%lld\n",merge_sort(1,n));
    return 0;
}
一个逆序对只有三种位置关系:完全在左半、完全在右半,或跨越左右两半。前两类由递归统计,第三类由当前层的合并统计,因此每个逆序对恰好计算一次。
比较相等元素时优先取左侧,因为逆序对要求严格大于。最多可能有
个逆序对;当 时,这个值超过 范围,计数必须使用 。排序与统计同时完成,时间复杂度为 。
6. 另一种“规模减半”:快速幂
给定非负整数 和正整数 ,计算 除以 的余数。规定 。
数据范围为 ,,。
按照乘方定义连续乘 次,需要 时间。指数可以按二进制拆分。例如
因此
从 开始不断平方,就能依次得到 。指数当前二进制位为 时,把对应的幂乘入答案;处理完这一位后,将指数整除 。
乘方表示重复相乘,指数相加对应乘积:,所以 。模运算只保留除以 的余数。若 、,展开乘积后除 外的项都含因子 ,因此每次乘法后立即取模不会改变最终余数。
计算 时,把 理解为已经选中的因子之积的余数, 为当前二次幂因子, 为尚未处理的指数:
| 轮次开始的 | 当前 | 最低位 | 选取后的 | 平方后的 、折半后的 |
|---|---|---|---|---|
例如第三轮 ,余数为 ;第四轮 ,余数为 。这里平方的是“当前因子”,每轮处理的是指数的一位,不能每轮都把最初底数乘一次。
程序输入一行 ,输出 。定义中约定指数为零时幂值为 ,也涵盖本教学模型的 。
#include <bits/stdc++.h>
using namespace std;
long long power(long long a,long long b,long long mod){
    long long ans=1%mod;
    a%=mod;
    while(b>0){
        if(b%2==1)ans=ans*a%mod;
        a=a*a%mod;
        b/=2;
    }
    return ans;
}
int main(){
    long long a,b,m;
    cin>>a>>b>>m;
    cout<<power(a,b,m)<<'\n';
    return 0;
}
记号 表示 、 除以 的余数相同。设最初的底数、指数和模数分别为 、 和 。每轮开始时都有
若 为奇数,先把当前的 乘入 ,剩余指数便成为偶数;随后把 平方、把 折半,上式仍然成立。循环结束时 ,所以 就是所求余数。
每轮都把 折半,时间复杂度为 ,额外空间为 。初值写成 ,可以正确处理 且 的情况。本节给定 ,两个余数相乘可以由 保存;若模数接近 上界,还需要专门处理乘法溢出。
快速幂和归并排序解决的问题不同,但都利用了“把规模缩小一半”。归并排序还要合并两个子问题的结果;快速幂只需根据指数的奇偶决定是否额外乘一次。
7. 递归构造:幂次方表示
把一个正整数写成若干个不同的 的幂之和,并按指数从大到小输出。 写成 2(0), 写成 2;指数大于 时,指数本身也要按同样规则表示。
数据范围为 。
例如,,所以 表示为 2(2)+2(0)。若要表示 ,指数 仍需按相同规则展开,于是结果为 2(2(2)+2(0))。
递归函数 负责输出整数 的完整表示。它先从高到低枚举 的二进制位:
- 指数为 时,直接输出
2(0); - 指数为 时,直接输出
2; - 指数大于 时,先输出
2(,递归输出这个指数,再输出)。
例如输出 :本层先发现指数 ,输出 2(,调用 ;子调用只输出 2,回到本层输出 ),此时已有 2(2)。本层继续到指数 ,先补 +,再输出 2(0),得到 2(2)+2(0)。子调用的 从真开始,不会改变上层已经输出过一项的记录。
这里 的作用只是检查整数 的第 个二进制位:右移 位使该位来到最低位,再与 按位与,得到 或 。在本题非负整数范围内,也可以把它理解为先整除 再对 取余。代码检查至第 位,覆盖题目上界;输出顺序必须从高位到低位。
#include <bits/stdc++.h>
using namespace std;
void print(int n){
    bool first=1;
    for(int k=30;k>=0;--k){
        if((n>>k)&1){
            if(!first)cout<<'+';
            first=0;
            if(k==0)cout<<"2(0)";
            else if(k==1)cout<<'2';
            else{
                cout<<"2(";
                print(k);
                cout<<')';
            }
        }
    }
}
int main(){
    int n;
    cin>>n;
    print(n);
    return 0;
}
变量 属于当前这一层调用,只记录本层是否已经输出过一项,因此连接符只会出现在相邻两项之间。递归调用处理的是指数 。只要第 位为 ,就有 ;当 时又有 ,所以递归参数严格减小,最终会到达指数 或 的直接输出规则。
每次递归都缩小到一个指数,嵌套深度很小。若输出长度为 ,这里每次调用固定检查 位,总时间为 (固定位宽视为常数),额外调用栈空间由指数反复取对数后的嵌套层数决定。不能只按最外层置位数量估计时间,因为指数内部也要输出。
这个例子与楼梯计数不同。递归不再用于返回一个数值,而是用于生成具有嵌套结构的输出。问题定义本身存在嵌套时,递归通常比循环更自然。
8. 从递归定义得到递推:数的计算
以 开始构造数列,可以立即停止,也可以在末尾加入一个不超过当前末项一半的正整数,再按相同规则继续。求合法数列的数量。
数据范围为 。
若当前末项为 ,有两类选择:
- 立即停止,得到 个合法数列;
- 选择 至 中的一个数 作为下一项,后续方案数等于以 开始的合法数列数。
令 表示以 开始的合法数列数,按第二项分类可得
第二项不同的方案互不重叠,所有非空扩展又一定会选择其中一个 ,所以转移不重不漏。右侧只依赖比 小的状态,可以从小到大计算。
先列出 的全部数列:、、、、、。按第二项分组,立即停止有一种,第二项为 有一种,为 有两种,为 有两种,合计六种。相同的后缀问题会从不同开头被用到,因此保存 后不必重新生成那些数列。
程序读入 ,输出数量。先保留直接求和的写法,便于逐项对应分类:
#include <bits/stdc++.h>
using namespace std;
int f[1010];
int main(){
    int n;
    cin>>n;
    for(int i=1;i<=n;++i){
        f[i]=1;
        for(int j=1;j<=i/2;++j)f[i]+=f[j];
    }
    cout<<f[n]<<'\n';
    return 0;
}例如,,,因此
直接按照转移求和的时间复杂度为 ,空间复杂度为 ,足以处理本题范围。若维护 的前缀和,每个状态的区间求和还能降到 ,总时间变为 。
还可以把第四章的前缀和用于转移。令 、,则 ,求出 后再令 。例如 只读 ,得到 。先求状态、后更新前缀,保证引用的都是更小下标。
下面是同一题的线性时间程序。 尚在 内,但前缀和会更大,统一以 保存状态和前缀。直接求和版本的 使用 也足够,因为各项非负且最终最大状态不超过该上界。
#include <bits/stdc++.h>
using namespace std;
long long f[1010],s[1010];
int main(){
    int n;
    cin>>n;
    for(int i=1;i<=n;++i){
        f[i]=1+s[i/2];
        s[i]=s[i-1]+f[i];
    }
    cout<<f[n]<<'\n';
    return 0;
}
这个过程再次说明:递归定义常常更接近题意,但真正计算时,可以根据依赖关系改写为递推,避免重复求解相同状态。
9. 复用有序结果:瑞士轮
共有 名选手,排名规则为总分从高到低,总分相同时编号从小到大。每轮由当前排名相邻的两人比赛,实力较高者得 分。经过 轮后,输出第 名选手的编号。
数据范围为 ,,;初始分数为 至 ,实力为 至 ,且两两不同。最多再增加 分,分数和实力均可用 保存。
最直接的做法是每轮比赛后重新排序,时间复杂度为 。不过,一轮比赛并没有完全破坏上一轮的顺序。
按旧排名依次收集本轮胜者。所有胜者都增加 分,因此任意两名胜者之间的分数差和编号优先级都没有改变,胜者序列仍然有序。败者都不加分,同理,败者序列也仍然有序。
于是,一轮结束后得到的不是一个任意乱序序列,而是两个分别有序的序列。使用本章开头的双指针合并,就能在线性时间内生成新排名。
取四位选手,初始分数依次为 ,实力依次为 。第一轮排名是 ,因此配对为 和 。选手 、 获胜:
| 序列 | 按旧排名收集的编号 | 更新后分数 | 为什么已排序 |
|---|---|---|---|
| 胜者 | 同时加一,原比较关系不变 | ||
| 败者 | 同时加零,原比较关系不变 |
合并时先取 (四分);随后胜者 和败者 都是三分,按编号先取 ;再取 ,最后取 。新排名为 。第二轮才按这个新顺序配对。
胜者有序还需要解释“按对局收集”为何等价于“按旧排名收集”:较早一场的两个位置都在较晚一场的两个位置之前,因此无论每场是谁赢,先收集的胜者都来自更早位置。对于两个胜者,旧分数不同,加一后大小关系保持;旧分数相同,加一后仍同分,原编号顺序也保持。败者同理。若把胜者按实力重新排列,这个证明就不再成立。
以下完整程序与原题输入输出一致。结构体让编号、分数、实力在排序和拷贝时一起移动。变量 对应题面的轮数 与询问名次 。字段 分别保存编号、分数和实力,数组 分别收集胜者、败者。 是唯一的排名规则,初始排序与最后合并都使用它;胜负则只由实力决定。
#include <bits/stdc++.h>
using namespace std;
const int N=200000+10;
struct node{
    int id,s,w;
};
node a[N],b[N],c[N];
bool cmp(const node &x,const node &y){
    if(x.s!=y.s)return x.s>y.s;
    return x.id<y.id;
}
int main(){
    int n,m,q;
    scanf("%d%d%d",&n,&m,&q);
    for(int i=1;i<=2*n;++i){
        scanf("%d",&a[i].s);
        a[i].id=i;
    }
    for(int i=1;i<=2*n;++i)scanf("%d",&a[i].w);
    sort(a+1,a+2*n+1,cmp);
    for(int t=1;t<=m;++t){
        int x=0,y=0;
        for(int i=1;i<=2*n;i+=2){
            if(a[i].w>a[i+1].w){
                ++a[i].s;
                b[++x]=a[i];
                c[++y]=a[i+1];
            }else{
                ++a[i+1].s;
                b[++x]=a[i+1];
                c[++y]=a[i];
            }
        }
        int i=1,j=1,k=1;
        while(i<=n&&j<=n){
            if(cmp(b[i],c[j]))a[k++]=b[i++];
            else a[k++]=c[j++];
        }
        while(i<=n)a[k++]=b[i++];
        while(j<=n)a[k++]=c[j++];
    }
    printf("%d\n",a[q].id);
    return 0;
}
初始排序需要 时间,每轮比赛和合并各需要 时间,总时间复杂度为 ,额外空间为 。
比赛必须先按照本轮开始时的名次全部完成,再统一合并胜者与败者。若处理一场比赛后立刻改变排名,就会影响本轮后续选手的配对。
这个例子没有把“归并”局限在归并排序中。只要一次更新后仍能得到少量有序序列,就可以考虑复用原顺序,再用线性合并恢复整体顺序。
10. 本章小结
- 递推需要明确状态、初值、转移和计算顺序。
- 递归需要明确函数职责、规模缩小方式和终止条件,并分别分析深度与总调用数。
- 分治包含分解、求解和合并;复杂度取决于递归层数与每层总工作量。
- 归并的核心是复用两个序列已经有序这一条件。
- 学会一个算法后,应继续寻找它维护的信息还能解决什么问题。逆序对复用了归并过程,瑞士轮复用了有序结果,快速幂则复用了规模减半的思想。
留言
可以匿名留言,无需注册或登录。昵称和邮箱均可不填,邮箱不会公开显示。
正在加载留言区…