第九章:栈、队列、堆与常用容器
第九章 栈、队列、堆与常用容器
算法不仅要确定“计算什么”,还要确定“以什么顺序保存和取出数据”。括号匹配需要取出最近出现且尚未匹配的左括号,缓存淘汰需要删除最早进入的对象,反复合并则需要取得当前最小值。取出顺序不同,适合的数据结构也不同。
先沿着“最后加入、最先加入、当前最小”三种需求比较栈、队列和堆,再用链表维护邻接关系。随后在栈和队列中加入一条新规则:有充分理由时永久淘汰候选,得到单调栈和单调队列。最后用一个姓名统计任务实际选择 set、map 和 vector。
阅读前需要掌握数组、字符串、结构体和函数。表达式部分只处理各节明确规定的语法。以下 C++ 代码块均可单独编译,不需要拼接前后代码块;每段程序的输入格式在附近说明。
1. 先根据操作确定保存方式
数据结构的选择取决于程序需要反复执行的操作,而不是数据的名称。可以先回答“每次需要取出谁”,再考虑具体容器。
| 反复执行的操作 | 适合的结构 | 核心顺序 |
|---|---|---|
| 取出最后加入的元素 | 栈 | 后进先出 |
| 取出最先加入的元素 | 队列 | 先进先出 |
| 取出当前最大值或最小值 | 堆 | 按优先级取出 |
| 已知结点编号,修改它的相邻关系 | 链表 | 保存前驱与后继 |
| 只保留将来可能成为答案的候选 | 单调栈、单调队列 | 淘汰被新元素支配的旧候选 |
同一种数据可以有不同需求。例如,按输入顺序处理任务只需要队列;任务随时加入且每次要取代价最小者,则更适合小根堆。若值域很小,只统计某个整数是否出现或出现多少次,数组通常比通用容器更直接。
2. 栈:处理最近加入的对象
栈遵循后进先出规则。STL 的 stack<int> st 用 st.push(x) 压栈,st.top() 读取栈顶,st.pop() 弹栈,st.empty() 判断空栈。
top() 只读取元素,pop() 才删除元素,而且 pop() 不返回被删除的值。需要使用栈顶值时,应先读取,再弹出。访问 top() 或执行 pop() 前必须确认栈非空。
数组也能模拟栈。令 top 表示当前元素个数,加入时写入 stk[++top],弹出时执行 --top,top==0 表示空栈。数组容量应覆盖最多同时存在的元素数。
2.1 括号匹配:最近的左括号先处理
考虑一个只包含 (、)、[、]、{、} 的字符串。若每个左括号都与同类型右括号匹配,而且嵌套顺序正确,则称括号序列合法。
只统计各种括号的数量并不足够。字符串 ([)] 中,每种左、右括号的数量都相等,但读到 ) 时,最近尚未匹配的左括号是 [,两者类型不同。
扫描字符串时,左括号暂时没有匹配对象,将它压入栈中;右括号只能与栈顶的左括号匹配。以 ([]) 为例,未匹配左括号栈依次为 (、([、(、空。此时栈底先进入、栈顶后进入,右括号只能关闭最内层仍未结束的括号。
输入一行只含这六种括号的字符串,长度不超过 ;允许空行。程序输出 YES 或 NO。
#include <bits/stdc++.h>
using namespace std;
const int N = 200000 + 10;
char st[N];
int top;
string s;
bool match(char a, char b)
{
    return (a == '(' && b == ')') || (a == '[' && b == ']') || (a == '{' && b == '}');
}
int main()
{
    getline(cin, s);
    for (char c : s)
    {
        if (c == '(' || c == '[' || c == '{')
        {
            st[++top] = c;
        }
        else
        {
            if (top == 0 || !match(st[top], c))
            {
                puts("NO");
                return 0;
            }
            top--;
        }
    }
    puts(top == 0 ? "YES" : "NO");
}
遇到右括号时,先检查栈是否为空,再访问栈顶,可以同时处理“右括号过多”和“类型不匹配”。扫描结束后还要检查栈空,才能排除仍有左括号未匹配的情况。
这段代码假定输入只包含六种括号。若题面还允许普通字符,需要另行规定这些字符是忽略、参与语法还是直接判错。每个字符最多入栈、出栈一次,时间复杂度和额外空间上界都是 。
2.2 后缀表达式:先保存操作数,再合并结果
后缀表达式把运算符写在两个操作数之后。例如,中缀表达式 对应的后缀表达式为
8 3 - 2 *从左向右扫描以空白分隔的记号:
- 遇到整数时,把它压入数字栈;
- 遇到运算符时,弹出最近得到的两个数,计算后把结果压回栈中。
上例的数字栈依次为 、、、、。减法和除法不满足交换律,先弹出的是右操作数,后弹出的是左操作数。
以下代码假设输入先给出记号数量 ,随后给出 个以空格分隔的记号,。表达式合法,不会除以 ,所有整数记号和中间结果均在 long long 范围内。特别地,不出现最小负整数除以 ,因为其数学结果超出这个范围。
#include <bits/stdc++.h>
using namespace std;
const int N = 200000 + 10;
int m, top;
long long stk[N];

int main()
{
    cin >> m;
    for (int i = 1; i <= m; ++i)
    {
        string s;
        cin >> s;
        if (s == "+" || s == "-" || s == "*" || s == "/")
        {
            long long b = stk[top--];
            long long a = stk[top--];
            if (s == "+")
            {
                stk[++top] = a + b;
            }
            else if (s == "-")
            {
                stk[++top] = a - b;
            }
            else if (s == "*")
            {
                stk[++top] = a * b;
            }
            else
            {
                stk[++top] = a / b;
            }
        }
        else
        {
            stk[++top] = stoll(s);
        }
    }
    cout << stk[top] << '\n';
}
弹栈后先得到右操作数 ,再得到左操作数 ,所以减法应计算 ,除法应计算 。按字符串记号读取,才能区分负整数 -12 和减号 -。C++ 的有符号整数除法向 截断,题面若采用其他取整方式,需要调整除法实现。
每个记号只入栈或触发一次计算,时间复杂度为 ,栈空间为 ,其中 是记号数量。
2.3 中缀表达式:用两个栈处理优先级
考虑一个不含空格,由非负整数、圆括号和二元运算符 +、-、*、/ 构成的合法中缀表达式。同一优先级的运算从左向右结合,除法使用 C++ 整数除法规则。输入一行表达式,长度不超过 ;每个数字、每个中间结果均可用 long long 表示,除数非零,也不出现最小负整数除以 。允许计算得到负数,例如 (2-5)*4;输入中的数字本身不带符号,所以 -3+4 不属于本节语法。
中缀表达式中的运算符可能要等待后面的高优先级部分,因此维护两个栈:
- 数字栈保存已经读完、但尚未全部合并的值;
- 运算符栈保存尚未执行的运算与左括号。
读到新运算符时,若栈顶运算符的优先级不低于它,栈顶运算应先执行。读到右括号时,则执行到对应左括号为止。左括号是一道边界,括号外的运算不能越过它。
例如,扫描 时,乘号的优先级高于栈顶加号,所以乘号先入栈等待;扫描结束后先计算 ,再计算 。对于 ,第二个减号到来时必须先计算同优先级的 ,才能得到左结合的 。
先把 2+3*4 的两个栈写出来。栈中从左到右表示从栈底到栈顶:
| 已读入内容 | 数字栈 | 运算符栈 | 本步动作 |
|---|---|---|---|
2 | 空 | 读完整个整数 | |
2+ | + | 等待右侧 | |
2+3 | + | 保留尚未合并的值 | |
2+3* | + * | 乘号优先级高,暂不执行加号 | |
2+3*4 | + * | 数字读完 | |
| 扫描结束 | ,再变为 | +,再变为空 | 先乘后加 |
再检查括号:处理 8/(3-1) 的右括号时,先把 算成 ,丢弃左括号;除号仍在栈中,最终计算 。括号内的减号不能被外层除号抢先执行。
#include <bits/stdc++.h>
using namespace std;
const int N = 200000 + 10;
string s;
long long num[N];
char op[N];
int tn, to;

int level(char c)
{
    if (c == '+' || c == '-')
    {
        return 1;
    }
    return 2;
}

void calc()
{
    long long b = num[tn--];
    long long a = num[tn--];
    char c = op[to--];
    if (c == '+')
    {
        num[++tn] = a + b;
    }
    else if (c == '-')
    {
        num[++tn] = a - b;
    }
    else if (c == '*')
    {
        num[++tn] = a * b;
    }
    else
    {
        num[++tn] = a / b;
    }
}

int main()
{
    cin >> s;
    int n = (int)s.size();
    for (int i = 0; i < n;)
    {
        if ('0' <= s[i] && s[i] <= '9')
        {
            long long x = 0;
            while (i < n && '0' <= s[i] && s[i] <= '9')
            {
                x = x * 10 + (s[i] - '0');
                ++i;
            }
            num[++tn] = x;
        }
        else if (s[i] == '(')
        {
            op[++to] = s[i++];
        }
        else if (s[i] == ')')
        {
            while (op[to] != '(')
            {
                calc();
            }
            --to;
            ++i;
        }
        else
        {
            while (to && op[to] != '(' && level(op[to]) >= level(s[i]))
            {
                calc();
            }
            op[++to] = s[i++];
        }
    }
    while (to)
    {
        calc();
    }
    cout << num[tn] << '\n';
}
数组 是数字栈, 是运算符栈, 与 分别是两个栈的栈顶。处理完表达式的一个前缀后,两个栈合在一起保存这个前缀尚未完成的计算。执行栈顶运算时,数字栈顶的两个值就是它已经完整读入的左右操作数。
多位数字必须连续读完再入栈。代码先计算当前字符的数值 s[i] - '0',再累加到 x * 10;括号保证中间过程不会先把字符编码加到一个已接近 long long 上界的数上。本节的输入数字只允许非负整数,运算符只允许二元运算符,因此 - 一定表示减法;若允许 -3 或 2*(-3),需要先区分一元负号与二元减法。若加入右结合运算符,同优先级时是否弹栈也要重新规定。
每个数字和运算符最多进出栈一次,时间复杂度为 ,两个栈共需 空间。栈保存的是“尚未完成的工作”;第十一章 模拟递归遍历时,还会在栈中记录回到一个结点后应继续哪个阶段,单有结点编号不足以还原全部递归执行过程。
2.4 题目限制可能让表达式更简单
题目只包含加法和乘法,不含括号,并要求输出结果除以 的余数。双栈算法在每次加法、乘法后取模也能处理它,但这里不必保存两个栈:加号把表达式分成若干连续乘积,只需维护当前乘积与已经结算的乘积和。
例如 2+3*4+5 被分成三个乘积 、、,最终得到 。读到第二个加号时,把当前乘积 加入已结算和;扫描完最后的 后,仍要再结算一次。输入一个合法的加乘表达式(不含空格,运算符不超过 个,每个整数为 至 ),输出其除以 的余数。
#include <bits/stdc++.h>
using namespace std;
const int mod = 10000;
int main()
{
    long long x;
    cin >> x;
    int sum = 0, mul = x % mod;
    char c;
    while (cin >> c >> x)
    {
        x %= mod;
        if (c == '*')
        {
            mul = mul * x % mod;
        }
        else
        {
            sum = (sum + mul) % mod;
            mul = x;
        }
    }
    printf("%d\n", (sum + mul) % mod);
}
sum 保存已经结算的乘积和,mul 保存当前乘积,两者都只保留除以 的余数。循环结束后还要结算最后一个乘积。新数先取模,所以相乘时两个因子都不超过 ;原始数字用 long long 读入即可。这里读到输入结束为止,所以 while (cin >> c >> x) 的读入检查承担结束条件。每次加法和乘法后取模不会改变最终余数;若表达式长度为 ,扫描时间为 ,额外空间为 。
2.5 前缀、中缀与后缀表达式的转换
前缀、中缀和后缀表达式只是同一棵表达式树的三种书写方式。以 为例:
| 写法 | 运算符位置 | 对应表达式 |
|---|---|---|
| 前缀表达式 | 写在两个子表达式之前 | *+ab-cd |
| 中缀表达式 | 写在两个子表达式之间 | (a+b)*(c-d) |
| 后缀表达式 | 写在两个子表达式之后 | ab+cd-* |
若把运算符看作表达式树的结点,把操作数看作叶子,那么三种写法分别对应:
- 前缀表达式:先序遍历,顺序为“根、左子树、右子树”;
- 中缀表达式:中序遍历,顺序为“左子树、根、右子树”;
- 后缀表达式:后序遍历,顺序为“左子树、右子树、根”。
手算转换时,可以先按照优先级和结合方向补全括号,再从最外层运算符递归处理左右两部分。例如
a+b*c
= a+(b*c)
最外层运算符是 +,右侧子表达式的根是 *,因此前缀形式为 +a*bc,后缀形式为 abc*+。这种方法保留了完整的表达式树,不容易把操作数顺序写反。
常见转换与扫描方向如下:
| 任务 | 扫描方向 | 遇到运算符时的处理 |
|---|---|---|
| 后缀表达式求值 | 从左向右 | 先弹右操作数,再弹左操作数 |
| 前缀表达式求值 | 从右向左 | 先弹左操作数,再弹右操作数 |
| 后缀还原中缀 | 从左向右 | 弹出右、左两段,合成 (左 op 右) |
| 前缀还原中缀 | 从右向左 | 弹出左、右两段,合成 (左 op 右) |
前缀和后缀表达式不需要括号,因为运算顺序已经由运算符位置唯一确定。还原中缀时添加的括号可以保证结构不变;若要删除多余括号,还需重新检查优先级和结合方向。
下面把中缀转后缀写成程序。输入是一个长度不超过 的合法表达式,操作数都是单个小写字母或单个数字,运算符只有左结合的 +、-、*、/,可含圆括号,不含空格。输出不带空格的后缀串。此处不能把 12 当成一个操作数;多位数字版本需要先切分记号,并在输出中加分隔符。
手算 a+b*c:a 立即输出,加号留栈;b 输出后遇到乘号,先不弹加号;读完 c,先输出乘号,再输出加号,得到 abc*+。操作数原来的左右顺序始终不变。
#include <bits/stdc++.h>
using namespace std;
const int N = 200000 + 10;
string s, ans;
char stk[N];
int top;

int level(char c)
{
    if (c == '+' || c == '-')
    {
        return 1;
    }
    return 2;
}

int main()
{
    cin >> s;
    for (char c : s)
    {
        if (('a' <= c && c <= 'z') || ('0' <= c && c <= '9'))
        {
            ans += c;
        }
        else if (c == '(')
        {
            stk[++top] = c;
        }
        else if (c == ')')
        {
            while (stk[top] != '(')
            {
                ans += stk[top--];
            }
            --top;
        }
        else
        {
            while (top && stk[top] != '(' && level(stk[top]) >= level(c))
            {
                ans += stk[top--];
            }
            stk[++top] = c;
        }
    }
    while (top)
    {
        ans += stk[top--];
    }
    cout << ans << '\n';
}
操作数立即输出,运算符在确定不会再等待更高优先级内容时输出。左括号只作为边界,右括号负责弹出这一层括号内的运算符,两个括号都不会进入结果。
中缀转前缀可以先转成后缀,再按下面的栈方法转成前缀。也可以反转原串、交换左右括号,进行一次中缀转后缀,最后反转结果;但这个反转法在中间扫描遇到同级运算符时,必须改用严格大于才弹栈。原来的左结合顺序被反转过一次:例如 a-b-c 必须得到 --abc,而不是表示 的 -a-bc。不要只反转字符串却原样照搬比较条件。
现在实现前缀与后缀之间的转换,同时还原全括号中缀。先手算后缀 ab-c/:读入 a,b 后遇到 -,先弹 b,再弹 a,合成中缀 (a-b)、前缀 -ab;读入 c 后遇到 /,合成 ((a-b)/c) 和 /-abc。每个栈元素保存的是一个完整子表达式,不是单个字符。
对于前缀 /-abc,从右往左读入 c,b,a,遇到 - 时先弹出的 a 是左侧,第二个弹出的 b 是右侧;最后的 / 再把 (a-b) 与 c 合在一起。两个方向都保留原来的左右关系。
输入第一行是模式和字符串:模式 1 表示前缀输入,模式 2 表示后缀输入。输入保证合法,长度不超过 ,操作数是单个小写字母或数字,运算符为四种二元运算。输出第一行为全括号中缀,第二行为另一种记法(前缀输入输出后缀,后缀输入输出前缀)。
#include <bits/stdc++.h>
using namespace std;
const int N = 2010;
int mode, top;
string s, a[N], b[N];
bool op(char c)
{
    return c == '+' || c == '-' || c == '*' || c == '/';
}
int main()
{
    cin >> mode >> s;
    if (mode == 1)
    {
        reverse(s.begin(), s.end());
    }
    for (char c : s)
    {
        if (!op(c))
        {
            a[++top] = string(1, c);
            b[top] = a[top];
        }
        else
        {
            string x = a[top], u = b[top];
            top--;
            string y = a[top], v = b[top];
            top--;
            if (mode == 2)
            {
                swap(x, y);
                swap(u, v);
            }
            a[++top] = "(" + x + c + y + ")";
            if (mode == 1)
            {
                b[top] = u + v + c;
            }
            else
            {
                b[top] = c + u + v;
            }
        }
    }
    cout << a[top] << '\n' << b[top] << '\n';
}
栈中每个字符串对应一个完整子表达式,因此每次合并都只会改变表示法,不会改变运算结构。最外层括号也保留,避免为了删括号再次处理结合方向。前面的中缀转后缀输出可以作为模式 2 的输入,从而得到前缀;由于这里显式复制字符串,这条转换路径只适用于本节的 字符限制。
这段实现的复杂度不是 。在 a+b+c+… 这样的链状表达式中,较长的子表达式会反复复制,累计复制量可达 。栈中也会残留弹出位置的字符串,空间按本实现保守估计为 。较大输入应记录表达式树的结点连接,最后一次遍历输出;第十一章 将讲解这种“先保存结构,再按先序、中序、后序访问”的办法。
这部分常见错误包括:
- 把减法、除法的左右操作数写反;
- 忽略同级运算从左向右结合,例如
a-b-c表示 ; - 中缀转前缀或后缀时,把括号当成运算符输出;反向还原中缀则需要括号保留结构;
- 把多位整数逐字符拆开。操作数不止一个字符时,输出结果需要用空格等分隔符区分记号;
- 加入右结合运算符后仍沿用同级弹栈规则。右结合运算符遇到同级运算符时不应立即弹栈。
3. 队列:处理最早加入的对象
队列遵循先进先出规则。STL 的 queue<int> q 用 q.push(x) 入队、q.front() 读取队首、q.pop() 出队、q.empty() 判断空队列。
访问 front() 或执行 pop() 前同样需要确认队列非空。数组模拟时,可以令 head=1,tail=0 表示空队列;入队写入 q[++tail],出队读取 q[head++]。若不循环复用数组位置,容量应覆盖累计入队次数,而不只是队列同时存在的最大元素数。
3.1 循环队列:复用已经离开的空间
如果容量为 的队列反复入队、出队,总入队次数可以远大于 。一直增大的尾下标会越过数组,而旧的空位置留在前面。解决方法是让下标到达末尾后回到 :下一个位置为 。
用 l 指向队首,r 指向下一次写入位置,cnt 保存元素数。空队列满足 cnt==0,满队列满足 cnt==m。两种状态下都可能有 l==r,所以不能只比较头尾下标来区分。
手算容量 :依次入队 后,数组为 [7,8,9],l=0,r=0,cnt=3。弹出 后,l=1,r=0,cnt=2;加入 时复用位置 ,数组成为 [10,8,9],但逻辑队列是 ,必须从队首沿环读取。
输入容量 、操作数 (均为 至 )。P x 尝试把 int 范围内的整数 入队,满时输出 FULL,成功时不输出;O 弹出并输出队首;F 只输出队首。后两种操作遇到空队列时输出 EMPTY。
#include <bits/stdc++.h>
using namespace std;
const int N = 200000 + 10;
int m, n, q[N], l, r, cnt;
int main()
{
    scanf("%d%d", &m, &n);
    for (int i = 1; i <= n; i++)
    {
        char c;
        scanf(" %c", &c);
        if (c == 'P')
        {
            int x;
            scanf("%d", &x);
            if (cnt == m)
            {
                puts("FULL");
            }
            else
            {
                q[r] = x;
                r = (r + 1) % m;
                cnt++;
            }
        }
        else if (cnt == 0)
        {
            puts("EMPTY");
        }
        else
        {
            printf("%d\n", q[l]);
            if (c == 'O')
            {
                l = (l + 1) % m;
                cnt--;
            }
        }
    }
}
每次操作只改变常数个位置,时间 ,总时间 ,空间 。容量 也使用同一套规则。这里增加 cnt 是为了明确使用全部 个位置;另一种实现可以空出一个位置来区分满与空,但两种约定不能混用。
第十章 的 BFS 也按先进先出取出状态,不过一个点是否应该入队由访问标记决定。通常在入队时就标记,才能阻止同一状态被多个前驱重复加入;只换成队列容器并不会自动消除重复。
3.2 按进入顺序淘汰:机器翻译
题意概述:缓存最多保存 个单词。读到未缓存的单词时,需要查询词典并把它加入缓存;若缓存已满,先删除最早进入缓存的单词。求查询词典的次数。
数据范围为 ,单词数 ,单词编号为 至 。
数组队列 q[l..r] 保存缓存中单词的进入顺序,布尔数组 has[x] 判断编号 当前是否在缓存中。二者维护的信息不同,入队和出队时必须同步修改。
例如缓存容量为 ,依次读入 。第三次读到 时命中缓存,队列仍是 ;读到 时,删除最早进入的 ,得到 。命中不会把单词移到队尾,因为题目采用先进先出规则,而不是按最近访问时间淘汰。输入第一行是容量 和单词数 ,第二行是 个编号。累计入队最多 次,所以队列数组按 开空间;标记数组则按编号不超过 开空间。
#include <bits/stdc++.h>
using namespace std;
const int N = 1010;
int n, m, q[N], l = 1, r, ans;
bool has[N];
int main()
{
    scanf("%d%d", &m, &n);
    for (int i = 1; i <= n; i++)
    {
        int x;
        scanf("%d", &x);
        if (has[x])
        {
            continue;
        }
        ans++;
        if (r - l + 1 == m)
        {
            has[q[l++]] = false;
        }
        q[++r] = x;
        has[x] = true;
    }
    printf("%d\n", ans);
}处理完每个单词后,队列从队首到队尾恰好按进入时间保存当前缓存内容,has 与队列中的集合完全一致。每个单词最多入队、出队一次,时间复杂度为 ;队列同时有效的编号最多 个,但这份不回绕的数组按累计入队数分配 空间,标记数组大小由编号范围决定。
3.3 按时间淘汰:海港
例题:NOIP 2016 普及组·海港。
题意概述:船按时间顺序到达。每艘船到达后,统计过去 小时内到达的乘客共有多少种不同国籍。到达时间恰好等于当前时刻减去 的乘客不计入。
船的时间有序,因此过期乘客一定从队首连续出现。队列中的每项保存乘客到达时间和国籍;频次数组保存窗口内各国籍人数,变量 ans 保存频次大于 的国籍数量。数组 qt、qx 分别保存队列中每名乘客的到达时间和国籍。
处理当前时刻 时,先从队首删除所有满足
的乘客,再加入当前船的全部乘客。删除时只有频次从 降到 才减少 ans;加入时只有频次从 增到 才增加 ans。
先手算三艘船:时刻 有国籍 ,种类数为 ;时刻 加入国籍 ,时刻 的乘客仍有效,种类数仍为 ;时刻 加入国籍 ,时刻 的三人全部过期,但国籍 还有时刻 的一人留下,结果是 种。过期一名乘客不一定删除一种国籍。
输入第一行是船数 ,随后每行依次是时间、人数、各乘客国籍。原题保证时间严格递增,,总人数 ,国籍编号不超过 ,时间不超过 。累计入队数组据此开空间,时间差可以用 int。
#include <bits/stdc++.h>
using namespace std;
const int N = 300000 + 10, V = 100000 + 10;
int n, qt[N], qx[N], cnt[V], l = 1, r, ans;
int main()
{
    scanf("%d", &n);
    for (int i = 1; i <= n; i++)
    {
        int t, k;
        scanf("%d%d", &t, &k);
        while (l <= r && qt[l] <= t - 86400)
        {
            if (--cnt[qx[l]] == 0)
            {
                ans--;
            }
            l++;
        }
        for (int j = 1; j <= k; j++)
        {
            int x;
            scanf("%d", &x);
            if (cnt[x]++ == 0)
            {
                ans++;
            }
            qt[++r] = t;
            qx[r] = x;
        }
        printf("%d\n", ans);
    }
}
队列负责回答“谁最早过期”,频次数组负责回答“某种国籍是否仍有其他乘客留在窗口中”。只使用其中一个结构都不足以高效维护不同国籍数。
设全部船只共有 名乘客。每名乘客恰好入队一次、出队至多一次,总时间复杂度为 ;数组队列空间为 ,频次数组空间由国籍编号范围决定。边界条件使用 <=,因为恰好在 到达的乘客已经不属于统计范围。
4. 堆:处理当前优先级最高的对象
普通队列按进入时间取出元素,堆则按优先级取出元素。声明 priority_queue<int> q 得到大根堆,堆顶为当前最大值。q.push(x) 插入,q.top() 读取堆顶,q.pop() 删除堆顶;读取和删除之前都必须保证非空。
声明 priority_queue<int, vector<int>, greater<int>> q 得到小根堆,把当前最小值放在堆顶。这里的 vector<int> 是堆保存元素的底层连续数组;greater<int> 指定优先取较小的值。
读取堆顶需要 时间,插入与弹出需要 时间。堆只保证堆顶是最值,不保证内部其余元素整体有序,也不适合直接删除任意指定的中间元素。
4.1 动态产生新候选:合并果子
题意概述:每次选择两堆果子合并,代价等于两堆重量之和。新堆还会参加后续合并,求把全部果子合成一堆的最小总代价。
本题的贪心结论是每次合并当前最小的两堆。堆不负责证明这条结论;它负责在旧重量不断删除、新重量不断加入时,高效取得新的最小两项。完整的最优性证明可以通过合并树中叶子的带权深度说明。
例如重量为 时,先合并 和 ,得到新重量 ;再合并 和 。总代价为 。再看 :第一次产生的 必须与原来的 比较,接下来应合并 ,最后 ,总成本 。若只把原数组相邻两项先配成 和 ,成本会变成 。
输入 和 个重量。原题 、每个重量不超过 ,并保证答案小于 ;这里保留 long long 累加,以便重量合并后的中间值也使用同一类型。
#include <bits/stdc++.h>
using namespace std;
int n;
long long ans;
priority_queue<long long, vector<long long>, greater<long long>> q;
int main()
{
    scanf("%d", &n);
    for (int i = 1; i <= n; i++)
    {
        int x;
        scanf("%d", &x);
        q.push(x);
    }
    while (q.size() > 1)
    {
        long long x = q.top();
        q.pop();
        long long y = q.top();
        q.pop();
        ans += x + y;
        q.push(x + y);
    }
    printf("%lld\n", ans);
}
堆中始终保存当前尚未合并的全部重量。每轮删除两项、加入一项,堆的大小减少 ,因此恰好执行 轮;当 时循环不执行,答案为 。总时间复杂度为 ,空间复杂度为 。
只在开始时排序一次并不足够,因为每次产生的新重量也必须参与后续最小值比较。若还要求按编号删除候选,需要额外的有效标记,或改用支持相应操作的数据结构。
第十一章 会把一次合并画成父结点,证明每次取最小两堆的哈夫曼贪心;这里先掌握候选怎样动态更新。如果规定只能合并位置相邻的两堆,任选最小两堆可能直接违法,例如 中两个 不相邻。这种限制在第十二章 用区间动态规划处理,不能套用本节堆程序。
5. 链表:修改已知结点的相邻关系
栈、队列和堆关心“下一次取出哪个元素”;链表解决的是另一类操作:已经知道某个结点的位置,需要快速修改它与相邻结点之间的连接。
考虑下面的任务:初始名单从左到右为 ,处理两种操作:
D x:删除仍在名单中的编号 ;Q x:查询编号 当前左右相邻的编号,没有相邻成员时输出 。
输入第一行给出 (均为 至 ),随后每行是一条操作,其中 。删除已不在名单中的编号时忽略,查询保证编号仍在名单中。为了同时查询左右邻居,使用数组 pre[x] 与 nxt[x] 分别保存编号 的前驱和后继,编号 表示不存在的邻居。
初始名单为 时,删除 需要完成两次更新:让 的后继变成 ,让 的前驱变成 。数据本身不需要搬动。接着删除 ,只需把 的前驱设为 ;再查 ,得到左邻居 、右邻居 。编号 是“没有邻居”的哨兵,不是一个真实成员。本实现不读写 pre[0] 或 nxt[0],因此左右端点都使用条件判断。
#include <bits/stdc++.h>
using namespace std;
const int N = 200000 + 10;
int n, m, pre[N], nxt[N];
bool live[N];
void del(int x)
{
    if (!live[x])
    {
        return;
    }
    int l = pre[x], r = nxt[x];
    if (l)
    {
        nxt[l] = r;
    }
    if (r)
    {
        pre[r] = l;
    }
    live[x] = false;
    pre[x] = nxt[x] = 0;
}
int main()
{
    scanf("%d%d", &n, &m);
    for (int i = 1; i <= n; i++)
    {
        pre[i] = i - 1;
        nxt[i] = (i == n ? 0 : i + 1);
        live[i] = true;
    }
    for (int i = 1; i <= m; i++)
    {
        char c;
        int x;
        scanf(" %c%d", &c, &x);
        if (c == 'D')
        {
            del(x);
        }
        else
        {
            printf("%d %d\n", pre[x], nxt[x]);
        }
    }
}
程序已经在 main 中完成初始化并处理操作。数组 live 标记编号是否仍在表中;del 先检查该标记,再修改邻接关系。
删除端点时,只更新实际存在的一侧;删除内部结点时,两侧都要更新。live 使重复删除不会再次破坏链表。题面保证不会查询已删除结点,否则还需要定义并处理这种操作的输出。
初始化需要 时间,每次删除或查询只访问常数个数组位置,需要 时间,所以总时间复杂度为 ,空间复杂度为 。
这里能用编号直接找到结点,是因为编号恰好作为数组下标。若操作只给出结点的值,仍可能需要额外结构定位结点。链表也不擅长访问“当前第 个元素”;从表头逐个寻找需要 时间。
6. 单调结构:永久淘汰无用候选
普通栈与队列主要规定取出顺序,单调结构还会删除将来不可能成为答案的元素。删除一个候选前,需要分别回答两个问题:
- 它为什么不适合作为当前答案?
- 新元素为什么能在所有未来情况中替代它?
单调栈通常处理“某一侧最近的更大或更小元素”。新元素从栈顶淘汰旧候选,剩余栈顶直接给出当前答案。单调队列还要处理滑动窗口边界:队首删除已经过期的位置,队尾删除被新元素支配的候选。
虽然实现中可能出现 while 循环一次弹出多个元素,但每个元素只会被压入一次、永久删除一次。总复杂度通常由这种累计次数得到,而不是假定每轮只弹出常数个元素。
7. 单调栈:寻找左侧最近的更小元素
给定长度为 的整数序列。对每个位置 ,寻找最大的下标 ,满足 且 ;若不存在,答案为 。
逐个位置向左扫描,在单调递减或大量相等的数据上可能反复检查同一批元素,最坏需要 时间。需要保留的只是那些仍可能成为未来答案的位置。
7.1 先手算候选变化
以序列 为例。栈中用“下标:值”记录候选:
| 当前位置 | 弹出的候选 | 当前答案 | 加入后的栈 |
|---|---|---|---|
| ,值为 | 无 | ||
| ,值为 | |||
| ,值为 | 无 | ||
| ,值为 |
处理最后一个 时,位置 的值与当前值相等,不能作为“严格更小”的答案。弹出它后,位置 才成为最近的严格更小位置。
7.2 为什么旧候选可以永久删除
处理当前位置 时,若栈顶位置 满足 ,则 对当前位置不合格。对于任意未来位置 :
- 若 ,则 ,位置 也合格,而且比 更近;
- 若 ,位置 本来就不合格。
因此,位置 不会再成为任何未来位置的最近严格更小元素,可以永久弹出。弹栈结束后,栈中下标递增、对应值严格递增;栈顶就是离当前位置最近的合格候选。
7.3 完整实现与复杂度
输入 和 个 int 范围内的整数,。输出一行 个下标。
以下栈保存下标。下标既能用于取得元素值,也能直接作为答案,还可以在其他问题中计算距离。
#include <bits/stdc++.h>
using namespace std;
const int N = 200000 + 10;
int n, a[N], st[N], top;
int main()
{
    scanf("%d", &n);
    for (int i = 1; i <= n; i++)
    {
        scanf("%d", &a[i]);
        while (top && a[st[top]] >= a[i])
        {
            top--;
        }
        printf("%d%c", top ? st[top] : 0, i == n ? '\n' : ' ');
        st[++top] = i;
    }
}
操作顺序是先淘汰不合格候选,再读取答案,最后把当前位置加入栈。若先入栈再查询,当前位置会被误当成自己的左侧元素。
每个下标入栈一次,之后最多弹出一次,总时间复杂度为 ,栈空间为 。若题目改为寻找左侧最近的小于等于当前值的位置,相等值应保留,弹栈条件需要从 >= 改为 >。
8. 单调队列:维护滑动窗口最值
例题:单调队列/滑动窗口。
题意概述:给定长度为 的整数序列和窗口长度 。窗口从左向右移动,依次输出每个窗口的最小值与最大值。
数据范围为 ,。
8.1 为什么只保存当前最小值不够
右端点为 时,窗口为 。每个窗口重新扫描 个元素,需要 时间,最坏达到平方级。
窗口和可以在移动时减去离开的值、加上新值,但最小值没有这样的逆运算。例如窗口 的最小值为 ;删除 后,只知道旧最小值无法判断剩余元素的最小值为 。因此还要保存可能接替队首的候选。
若旧位置 与新位置 满足 且 ,旧位置可以永久删除:
- 新值不大于旧值,作为最小值候选至少同样好;
- 新位置更靠右,离开窗口的时间更晚。
此后任何仍包含 的窗口也包含 ,所以 不会提供更小答案。依次读入 时, 可以被 替代;依次读入 时, 必须保留,因为 先过期后,它可能成为新的最小值。
8.2 队首删除过期位置,队尾删除劣势候选
用双端队列保存候选下标。维护窗口最小值时,下标从队首到队尾递增,对应值也严格递增。处理新位置 时按以下顺序执行:
- 从队首删除下标小于 的位置,它们已经离开窗口;
- 从队尾删除满足 的位置,它们被新位置替代;
- 把 加入队尾;
- 若已经形成完整窗口,队首对应的值就是窗口最小值。
下标递增使过期位置集中在队首,值递增使不小于新值的候选集中在队尾。窗口左端 本身仍然有效,所以过期条件使用严格小于。
相等值可以删除较早位置,因为题目只要求最值,较晚位置能保留更久。若题目还要求最小值最早出现的位置,则需要保留相等候选,并相应改变队尾比较条件。
8.3 手算队列变化
取序列 ,窗口长度 。表中用“下标:值”表示候选。
| 读入位置 | 从队首删除 | 从队尾删除 | 加入后的候选队列 | 当前窗口最小值 |
|---|---|---|---|---|
| 无 | 无 | 尚未形成完整窗口 | ||
| 无 | 尚未形成完整窗口 | |||
| 无 | ||||
| 无 | 无 | |||
| 无 | 无 | |||
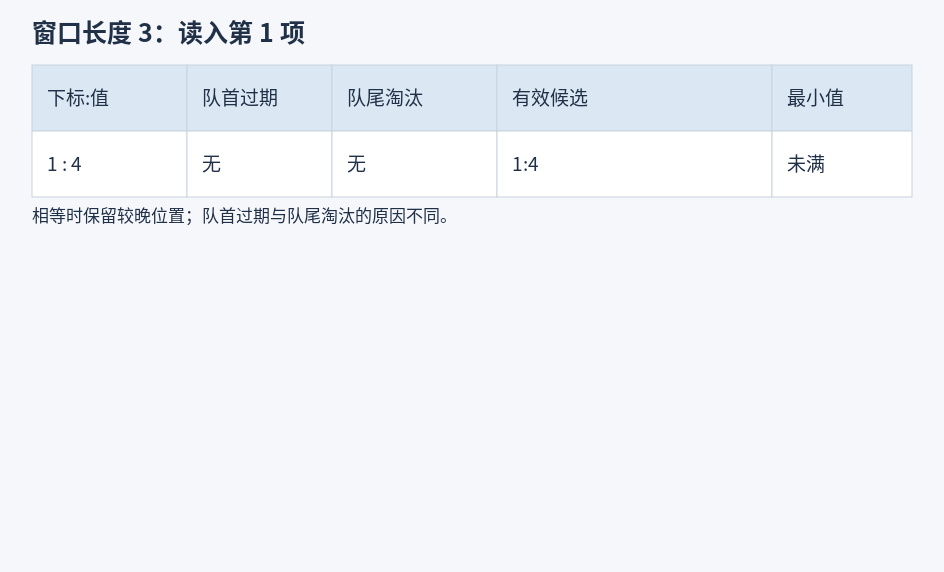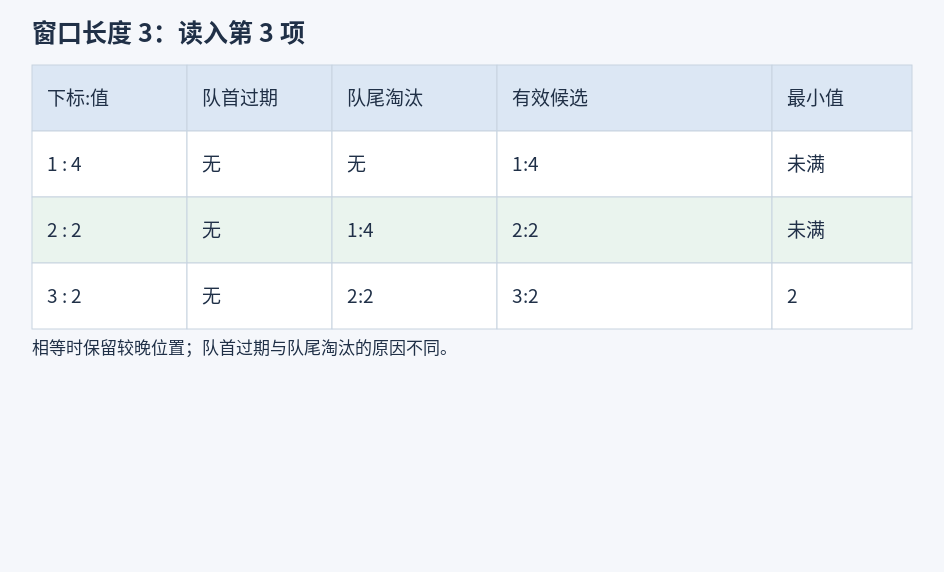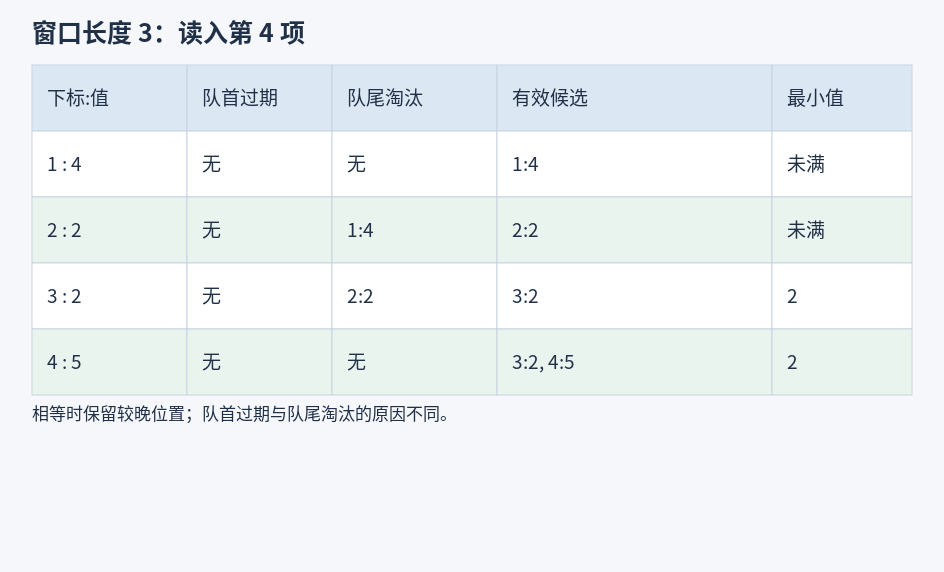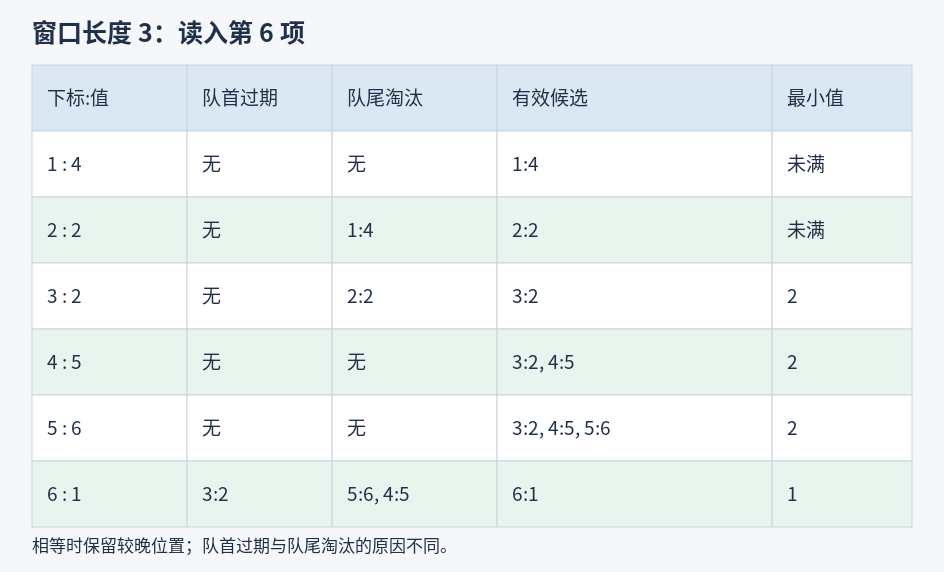
处理位置 时,窗口为 。位置 从队首删除,是因为它已经过期;位置 和 从队尾删除,是因为新值 在数值和有效时间上都更优。两类删除的原因不同。
8.4 数组实现与均摊复杂度
以下使用数组模拟双端队列。l 与 r 指向有效区间两端,l=1,r=0 表示空队列。
#include <bits/stdc++.h>
using namespace std;
const int N = 1000000 + 10;
int n, k, a[N], q[N];
void solve(bool mx)
{
    int l = 1, r = 0;
    for (int i = 1; i <= n; i++)
    {
        while (l <= r && q[l] < i - k + 1)
        {
            l++;
        }
        while (l <= r && (mx ? a[q[r]] <= a[i] : a[q[r]] >= a[i]))
        {
            r--;
        }
        q[++r] = i;
        if (i >= k)
        {
            printf("%d%c", a[q[l]], i == n ? '\n' : ' ');
        }
    }
}
int main()
{
    scanf("%d%d", &n, &k);
    for (int i = 1; i <= n; i++)
    {
        scanf("%d", &a[i]);
    }
    solve(false);
    solve(true);
}
函数 solve(false) 输出最小值,solve(true) 输出最大值。参数 mx 只改变队尾比较方向:求最小值时删去不小于新值的候选,求最大值时删去不大于新值的候选。两个调用各自重新初始化 l=1,r=0,不会把上一轮的候选带入下一轮。
每个下标在一轮扫描中入队一次,之后最多从队首或队尾删除一次,所以一轮的总时间为 ;两轮仍为 。数组实现连同原序列需要 空间,队列同时存在的有效候选不超过 个。
当 时,每个窗口只含当前元素;当 时,只产生一个窗口。单调递增序列会保留多个最小值候选,单调递减序列会频繁淘汰队尾,相等序列则检验相等值的处理。这些数据适合检查边界与比较符号。
单调队列也能用于左右端点只向右移动的变长窗口,但需要重新证明候选替代关系与过期规则。仅凭题目出现“连续区间”,还不足以确定可以使用本节模板。
9. 按关键字访问与动态数组
栈、队列和堆规定了取出顺序;另一些任务更关心按关键字查找,或者需要长度动态变化的连续数组。先比较常用语义与限制,再通过姓名统计任务确定每种容器保存的信息。
| 容器 | 维护的信息 | 常用操作与限制 |
|---|---|---|
set<int> | 不同整数构成的有序集合 | insert(x)、erase(x)、count(x);重复插入不增加副本 |
map<string, int> | 字符串到整数的有序映射 | find(key) 查找;value[key] 在键不存在时会插入默认值 |
vector<int> | 长度可变的连续序列 | push_back(x) 加入尾部,pop_back() 删除非空尾部,按下标随机访问 |
集合与映射的插入、查找和删除通常需要 次关键字比较;字符串关键字的一次比较还可能检查多个字符。值域较小且固定时,数组标记或计数通常更直接。
vector 的有效下标为 至 size()-1。reserve 只预留容量,不会增加有效元素数量;中间插入或删除可能移动线性数量的元素;扩容后,指向旧存储区的地址与迭代器可能失效。
把容器放进一个实际任务
给出一份不能参加统计的姓名名单,再按到达顺序给出若干姓名。忽略名单中的人,对其他姓名统计出现次数,并按这些姓名第一次出现的先后顺序输出。
如果每次都在线性数组里寻找姓名是否已出现, 次记录最多做平方级次字符串比较。这里需要三种不同信息:set<string> ban 判断姓名是否被排除;map<string,int> cnt 保存参加统计的姓名与次数;vector<string> a 保存它们首次出现的顺序。map 按姓名排序,并不会记住第一次出现的先后,所以单独遍历 map 不能满足输出要求。
例如排除名单为 Li,到达顺序为 Zhou Li Wu Zhou。读到 Zhou,记录次数 并在顺序表追加;跳过 Li;读到 Wu 再追加;第二个 Zhou 只增加次数。最后输出 Zhou 2、Wu 1,不是按字母顺序输出 Wu 在前。
输入第一行是排除姓名数 和到达记录数 ,随后给出 个排除姓名和 个到达姓名;、,每个姓名是长度 至 的英文字母串,区分大小写。输出第一行为参加统计的不同姓名数,之后按首次到达顺序逐行输出姓名与次数。
#include <bits/stdc++.h>
using namespace std;
int k, n;
set<string> ban;
map<string, int> cnt;
vector<string> a;
int main()
{
    cin >> k >> n;
    for (int i = 1; i <= k; i++)
    {
        string s;
        cin >> s;
        ban.insert(s);
    }
    for (int i = 1; i <= n; i++)
    {
        string s;
        cin >> s;
        if (ban.count(s))
        {
            continue;
        }
        if (cnt.find(s) == cnt.end())
        {
            a.push_back(s);
        }
        cnt[s]++;
    }
    cout << a.size() << '\n';
    for (string s : a)
    {
        cout << s << ' ' << cnt[s] << '\n';
    }
}
find 只查询,不增加键;随后使用 cnt[s]++,新姓名会先得到默认值 再加一。顺序表只在第一次出现时追加,因此没有重复。vector 不需要提前知道最终有多少不同姓名,push_back 负责增长;这里无需使用 reserve 或手动下标写入。
若姓名最大长度为 ,总时间为 ,保存名单、计数与顺序需要 空间。这个估计把字符串比较成本也算在内。若姓名已经是 至 的整数编号,用布尔数组、计数数组和编号顺序数组就足够。
10. 怎样选择数据结构
面对新的维护问题,可以按以下顺序分析:
- 列出插入、删除、查询三类操作及其执行次数;
- 确定每次取出的是最后加入、最先加入还是当前最值;
- 检查元素是否会按时间、位置或其他边界过期;
- 判断新元素能否永久替代某些旧候选;
- 检查值域是否允许用数组直接定位;
- 估算每个元素进入和离开结构的次数。
容器接口只是实现工具。真正决定算法正确性的,是结构中保存的信息是否足以回答查询,以及每次删除是否有明确依据。
11. 本章小结
- 栈按后进先出处理最近加入的对象,适合括号嵌套与表达式运算。
- 队列按先进先出处理最早加入的对象,适合按进入时间或到达时间淘汰。
- 堆动态维护当前最值,但不会自动证明使用最值的贪心策略正确。
- 双向链表通过前驱与后继数组,在已知结点位置时完成常数时间删除。
- 单调结构只保留未来仍可能成为答案的候选;每次永久删除都需要支配关系作为依据。
- 单调队列的队首过期与队尾淘汰解决的是两个不同问题。
12. 作业
巩固练习
- 表达式括号匹配:原题只有圆括号,允许其他表达式字符,并用
@结束;本章六种括号程序不能原样提交,需要忽略普通字符并处理结束符。 - NOIP 2010 提高组·机器翻译
- NOIP 2004 提高组·合并果子
提高训练
完成练习时,应先写出结构中每个元素的含义,再说明入结构、出结构和查询的条件。单调结构还应解释旧候选为什么以后也不会成为答案。